



AI schalen voor echte zakelijke winst: bewezen strategieën voor operationeel succes
Kunstmatige intelligentie (AI) stuurt een nieuwe norm voor bedrijven in alle industrieën. Detailhandelaren kunnen bijvoorbeeld AI gebruiken om inkooporders te voorspellen op basis van historische voorraaddata om intelligente heraanvullingsbeslissingen te drijven. Klantenserviceteams kunnen AI gebruiken om automatisch te reageren op en hoog-prioriteit klantenservicetickets door te sturen naar de juiste teams. Er is een wereld aan mogelijkheden waar je AI, en specifiek ML, kunt gebruiken om praktische zakelijke resultaten te drijven.
Volgens Deloitte Insights zagen 83% van de enterprise AI vroege adopters een positieve return on investment (ROI) van projecten in productie. Deze omvatten voorbeelden zoals de implementatie van derde-partij enterprise software met AI, gebruik van chatbots en virtuele assistenten, en aanbevelingsmachines voor e-commerce platforms. Drieëntachtig procent van de befragde bedrijven plande de uitgaven aan AI in 2019 te verhogen. Van de enterprises die in AI investeren, had 63% ML geadopteerd.
Een strategie bouwen voor het pragmatisch gebruik van AI en ML om zakelijke doelen te bereiken, is een top-prioriteit voor veel enterprises. Voor velen is de hoofduitdaging om ML succesvol te operationaliseren het begrijpen, plannen en uitvoeren van het beheer van een holistische ML-implementatie in de hele organisatie.
Belangrijkste overwegingen voor het operationaliseren van ML
De 'juiste' manier om de data science levenscyclus aan te pakken, verschilt per organisatie. Er zijn veel pogingen gedaan om data science levenscyclus-procedures te codificeren en te standaardiseren. Echter, geen enkele benadering omvat de behoeften van elk enterprise.
Een duurzame en onderhoudbare strategie voor data en data science omarmen is een zich voortdurend ontwikkelende oefening die uniek is voor elk enterprise. Omdat elke bedrijfs behoeften, structuur en capaciteiten uniek zijn, moeten stakeholders uit het hele enterprise geraadpleegd worden om een flexibel en schaalbaar ML-model te bouwen en een holistische data science-strategie uit te voeren.
De operationele uitdagingen en veranderingen in infrastructuur en ontwikkelpraktijken die elk enterprise moet aanpakken, zullen verschillen.
Het is cruciaal dat jouw organisatie rekening houdt met jouw cultuur, systemen en behoeften tijdens het definiëren en evolueren van de data science levenscyclus. Een basisframework om over teams heen te presenteren, helpt een gemeenschappelijke basis voor communicatie te ontwikkelen terwijl je doorgaat met het ontwikkelen en evolueren van je operationalisering van ML.
Laten we doorlopen door een standaardframework dat je organisatie kan helpen om te starten met de ML-reis.
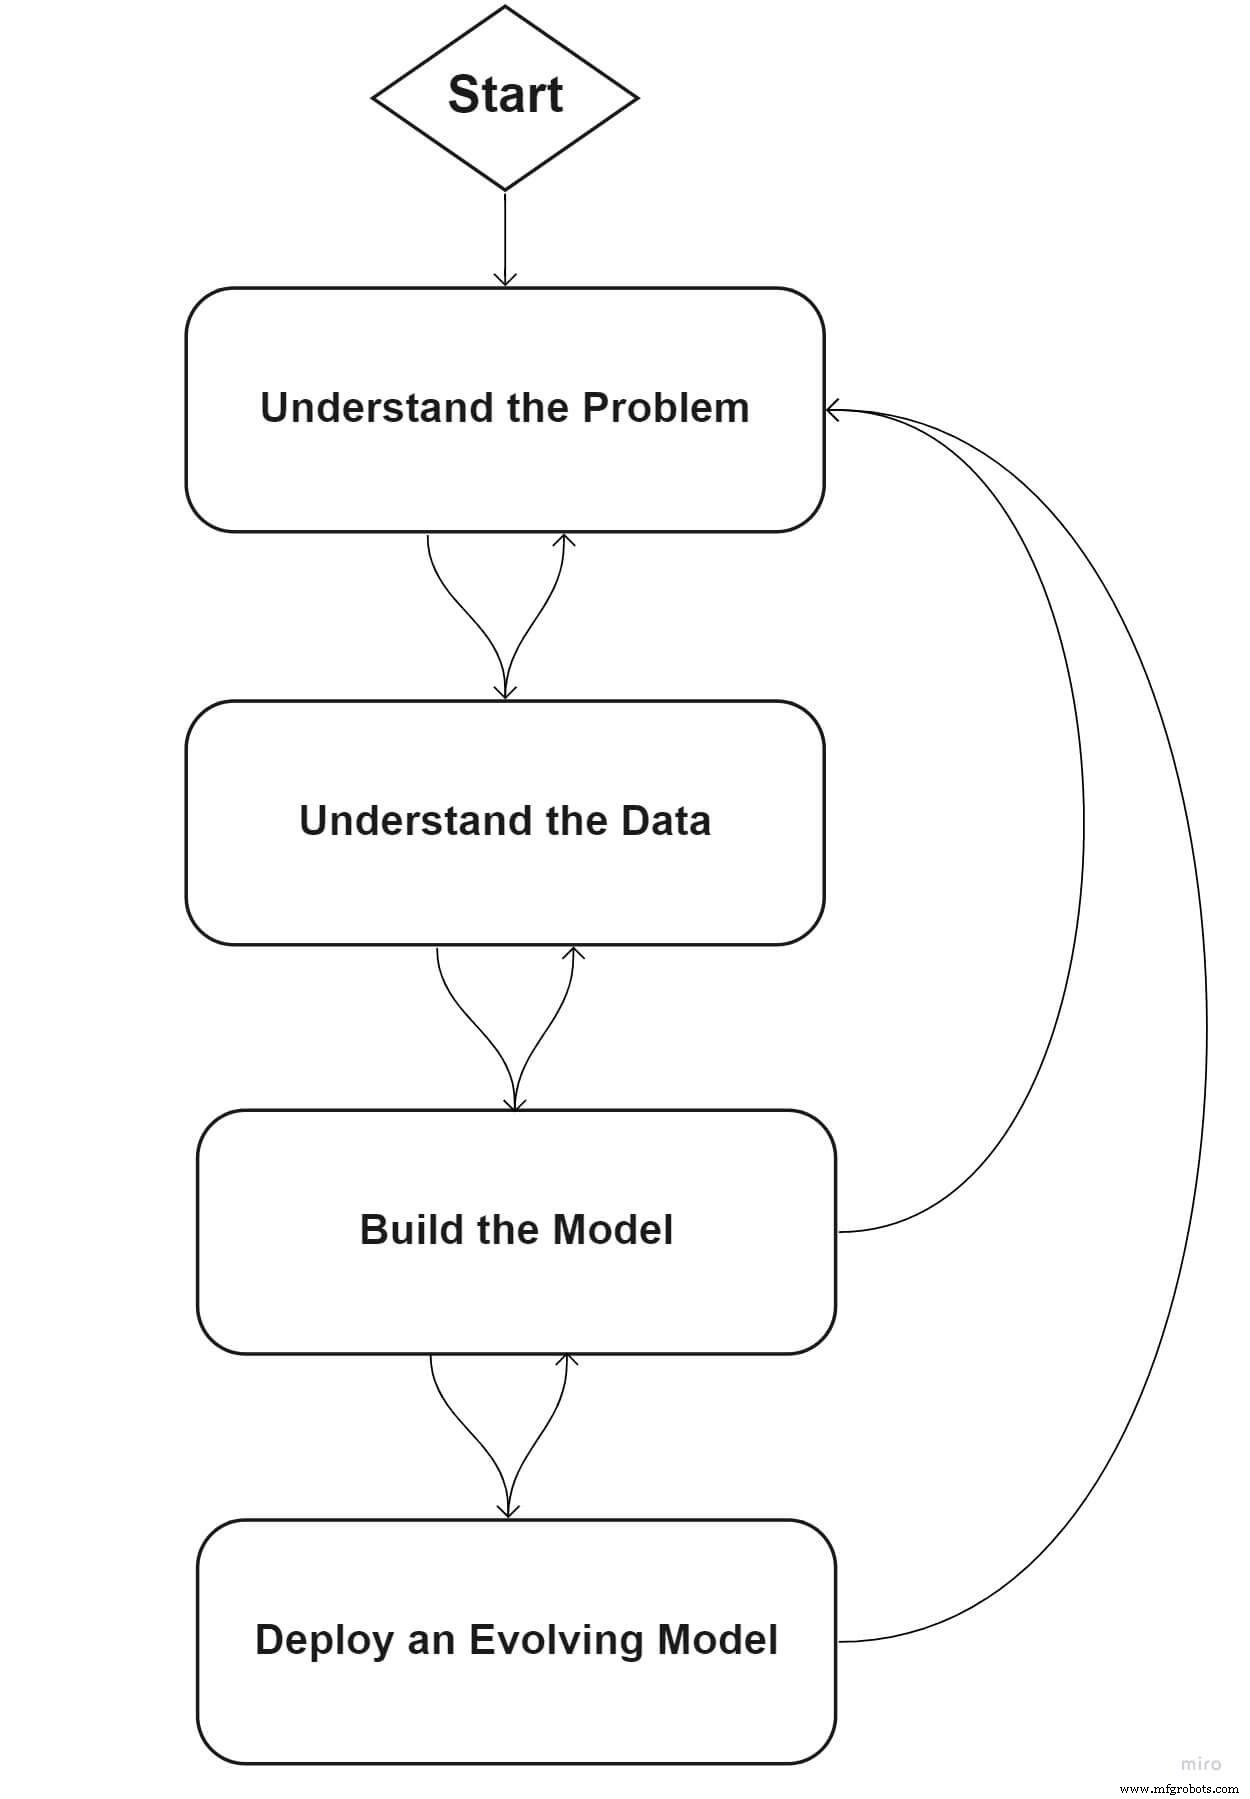
Fase één: Definieer je probleem
In de kern van elk ML-initiatief liggen twee vragen:
1. Welk probleem probeer je op te lossen?
2. Waarom geloof je dat ML en een beter begrip van je data je kan helpen het probleem op te lossen?
De antwoorden op deze vragen hangen af van hoe je bedrijf denkt over strategie en zakelijke problemen evalueert.
Tijdens fase één moeten belangrijke stakeholders samenkomen om de initiële omvang van het probleem en zijn vereisten te definiëren.
Fase twee: Begrijp je data
Wat is het verhaal van je data? Waar komt je data vandaan, en hoeveel databronnen zijn relevant om je specifieke zakelijke probleem op te lossen?
Tijdens deze fase richten enterprises zich op:
Relevante databronnen en de omgevingen waarin ze leven in kaart brengen (dergelijke omgevingen kunnen on-premises of in de cloud zijn, ingesteld als data warehouse, data lake, of streaming data platforms)
Bepalen welke datapijplijnen momenteel bestaan, en welke datapijplijnen gebouwd moeten worden voor datavalidatie, opschoning en verkenning
Begrijpen hoe frequent data wordt bijgewerkt
Het vertrouwdheid van de data begrijpen
Dataprivacy-overwegingen en -vereisten evalueren
Dataverkenning mogelijk maken door visualisaties, statistische eigenschappen van ruwe en getransformeerde data, etc.
Je data begrijpen is geen kleine klus. Het is belangrijk om deze fase iteratief aan te pakken. Naarmate je meer over je data ontdekt, kun je problemen ontdekken die je vermogen om het probleem op te lossen beïnvloeden, wat verder kan vereisen dat je het probleem uit fase één herschrijft of herscopert.
Fase drie: Bouw het ML-model
Eenmaal je de data klaar hebt, is het tijd voor je data scientists om een ML-model te bouwen. Veelvoorkomende stappen om een robuust ML-model te bouwen omvatten:
Features extraheren en engineeren (omvat binning, data whitening, en statistische transformaties toepassen)
Features selecteren
Het model trainen (omvat het splitsen van de data in willekeurig aantal training, cross-validatie, en validatie datasets)
Hyperparameters tunen
Het model evalueren
Statistische significantie valideren
Het ontwikkelen van een model vereist lopende feedback van zakelijke stakeholders. Het zakelijke probleem kan bijvoorbeeld een affiniteit voor sensitiviteit ten opzichte van specificiteit vereisen. Je kunt ook lichtvoorrellende prestaties (bijv. F1-score) inruilen voor operationele modelprestaties (bijv. snellere voorspellingen), of modelexplainability.
Het doel van de data scientist is om een model te bouwen dat data gebruikt om een helder verhaal te vertellen gerelateerd aan het zakelijke probleem. Naarmate het probleem evolueert en vereisten veranderen, moet de benadering van modellering ook evolueren om de huidige context te dienen.
Fase vier: Implementeer een evoluerend model
Het bouwen van het initiële model is slechts het begin van de ML-reis. Een evoluerend model implementeren is een cruciale stap voor langetermijnwaardecreatie voor de organisatie.
Een evoluerend model implementeren vereist:
Het model serveren (het model hoog beschikbaar en horizontaal schaalbaar maken)
Modelversies beheren (inclusief rollbacks en canary/challenger deployments)
Het model her trainen (het model wijzigen of een nieuw model bouwen naarmate nieuwe data in het systeem komt)
Het model monitoren (zowel operationele als gebruikerservaring metrics bij serveren en trainen volgen)
Data- en modeldrift monitoren, specialisatie van een model voor gerichte intra-organisatie use cases vereisen, en datapijplijnen onderhouden (onder andere onderhoudsitems) zijn cruciaal voor de lopende succes van een model.
Enterprise-brede en industrie-brede vereisten kunnen snel evolueren en databronnen en inputs beïnvloeden. Bijvoorbeeld, governance en compliance op schaal zijn overwegingen die de volledige data science levenscyclus beslaan.
Naleving van reguleringen – zoals de Europese Unie (EU) Algemene Verordening Gegevensbescherming (GDPR) – vereist een dieper niveau van traceerbaarheid op de data-versiebeheer, model-versiebeheer, en model-input lagen. Een strategie bouwen om te reageren op deze industrieveranderingen en -vereisten door data, kan bedrijven helpen ML te blijven benutten om betere zakelijke resultaten te drijven zoals omzetgroei, kostenreductie en verminderd risico.
Wat is er verder?
ML operationaliseren op een flexibele, onderhoudbare en schaalbare manier vereist veel stappen en overwegingen buiten de hoogste scope van wat we in deze blog hebben uiteengezet. De duivel zit in de details.
In onze volgende blog duiken we dieper in technische overwegingen, uitdagingen die kunnen rijzen uit een ad-hoc implementatie van een grootschalig ML-systeem, en hoe UiPath helpt bij het aanpakken van veelvoorkomende uitdagingen voor enterprise-klanten.
Automatisering Besturingssysteem
- Bosch onthult AI-gedreven productieoplossing op Hannover Messe
- AI-gedreven testautomatisering: QA voor moderne ERP-systemen revolutioneren
- Business Intelligence uitgelegd: Waarom het voor uw organisatie belangrijk is
- AI-gestuurde Robotica: High-tech Intelligente Machines
- Business Intelligence onder de knie krijgen: Een winnende strategie voor data-gestuurd succes
- AI: Voordelen, risico's en industriële impact
- Big Data vs AI: Synergie achter digitale transformatie
- Kunstmatige Intelligentie in Detailhandel: Bewezen Voordelen, Geen Hype
- Hoe AI de Internet of Things-revolutie versnelt
- Hoe Artificiële Intelligentie de Kracht van het Internet of Things Versterkt
- Industriële AIoT: AI en IoT samensmelten om Industry 4.0-innovatie te drijven