



Diep Lerende Voorspellend Netwerk voor Metamateriaalontwerp met Split-ring Resonatoren
Samenvatting
De invoering van "metamaterialen" heeft een diepe impact gehad op verschillende velden, waaronder elektromagnetisme. Het ontwerpen van de structuur van een metamateriaal op verzoek is echter nog steeds een extreem tijdrovend proces. Als een efficiënte machine learning-methode is diep leren in de afgelopen jaren wijd gebruikt voor dataclassificatie en regressie en heeft in feite goede generalisatieprestaties getoond. We hebben een diep neuraal netwerk gebouwd voor op-verzoek ontwerp. Met de vereiste reflectantie als invoer, worden de parameters van de structuur automatisch berekend en vervolgens uitgevoerd om het doel van op-verzoek ontwerpen te bereiken. Ons netwerk heeft lage gemiddelde kwadraatsfouten (MSE) behaald, met MSE van 0,005 op zowel de trainings- als testsets. De resultaten wijzen erop dat door diep leren de data te trainen, het getrainde model de ontwerp van de structuur nauwkeuriger kan begeleiden, waardoor het ontwerpproces versneld wordt. Vergeleken met het traditionele ontwerpproces, kan het gebruik van diep leren om het ontwerp van metamaterialen te begeleiden snellere, nauwkeurigere en gemakkelijkere doeleinden bereiken.
Inleiding
Nano-optica is een interdisciplinair vakgebied van nanotechnologie en optica. In de afgelopen jaren, door constant structuren met verschillende sub-golflengte afmetingen te ontwerpen om speciale interacties met invallicht te bereiken, zijn wetenschappers geslaagd in het manipuleren van bepaalde transmissie-eigenschappen van licht. Sinds metamaterialen voorgesteld werden, hebben ze de aandacht van veel onderzoekers in dit veld getrokken, en gelijktijdig zijn hun gerelateerde theoretische studie, proces en toegepast onderzoek allemaal met dezelfde snelheid gevorderd. Veel bijzondere functies zijn gerealiseerd, waaronder holografische imaging, perfecte absorptie en platte lenzen. Vanwege de snelle ontwikkeling van terahertztechnologie en zijn unieke kenmerken, is het ook een populair onderzoeks onderwerp in het veld van metamaterialen in de laatste jaren geworden.
Hoewel de toepassing van metamaterialen zeer wijd is, vereist de traditionele ontwerpmethode dat de ontwerper herhaaldelijk complexe numerieke berekeningen uitvoert op de te ontwerpen structuur. Dit proces verbruikt enorme tijd en rekenbronnen. Daarom is het dringend nodig om nieuwe manieren te vinden om traditionele ontwerpmethoden te vereenvoudigen of zelfs te vervangen.
Als een kruisdisciplinair veld, omvat machine learning veel disciplines waaronder levenswetenschappen, informatica en psychologie, het heeft gewerkt om computers te gebruiken om menselijke leerprocessen na te bootsen en te implementeren om nieuwe kennis of vaardigheden te verwerven. Het basisprincipe van machine learning kan eenvoudig worden beschreven als het gebruik van computergoritmes om de correlatie tussen een grote hoeveelheid data te verkrijgen of om de regels tussen vergelijkbare data te voorspellen en uiteindelijk het doel van classificatie of regressie te bereiken. Tot nu toe zijn veel machine learning-algoritmen toegepast op de designatie van metamaterialen en hebben significante resultaten behaald, waaronder genetische algoritmen, lineaire regressie-algoritmen en ondiepe neurale netwerken. Naarmate de structuur complexer wordt en de veranderingen in de structuur diverser worden, zullen problemen meer tijd vereisen om op te lossen. Tegelijkertijd maakt de sterk niet-lineaire aard van de problemen het moeilijk voor eenvoudige machine learning-algoritmen om nauwkeurige voorspellingen te verkrijgen. Bovendien vereist het ontwerpen van een passende metamateriaalstructuur voor een specifiek elektromagnetisch effect dat ontwerpers proberen en complexe numerieke berekeningen op de structuur uitvoeren. Deze processen zullen een enorme hoeveelheid tijd en rekenbronnen verbruiken.
Als een van de meest uitstekende algoritmen in het veld van machine learning, heeft diep leren wereldberoemde prestaties geboekt in verschillende gerelateerde velden zoals computervisie, kenmerkextractie en natuurlijke taalverwerking. Tegelijkertijd zijn successen in andere niet-computergerelateerde velden talloos, waaronder veel basisdisiplines zoals levenswetenschappen, scheikunde en natuurkunde. Daarom is het toepassen van diep leren op het ontwerp van metamaterialen ook een heet onderzoeksrichting op dit moment, en zijn veel uitstekende werken verschenen.
Theorie en Methode
COMSOL Model Bouwen
Om aan te tonen dat diep leren toegepast kan worden op het omgekeerde ontwerp van metamateriaalstructuren, hebben we een drie-laags SRR-structuur gemodelleerd bestaande uit een gouden ring, een silice bodem en een gouden bodem om de elektromagnetische respons ervan te observeren onder de werking van invallicht. Zoals getoond in Fig. 1, worden de openinghoek θ van de gouden ring, de binnenstraal r van de ring en de lijndikte d van de ring geselecteerd als onafhankelijke variabelen van deze structuur. Wanneer een bundel lineair gepolariseerd licht normaal de metamaterialen binnenkomt, worden de golflengte-reflectantiecurves onder verschillende structuren verkregen door de structurele variabelen te veranderen. De dikte van de Au-ring is 30 nm, van de SiO2-bodem 100 nm, en van de Au-bodem 50 nm, en de grootte van de meta-atomen is 200 nm bij 200 nm.
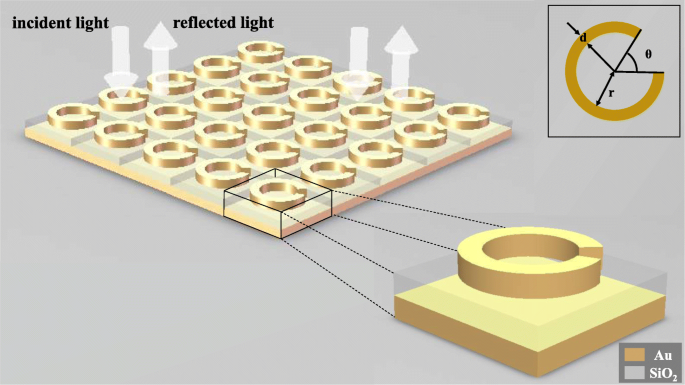
Gebruik COMSOL Multiphysics 5.4 voor modellering, kies driedimensionale ruimtedimensie, kies optica ≥ golfoptica ≥ elektromagnetische golf frequentiedomein (ewfd) voor het fysische veld en selecteer het golflengtedomein voor onderzoek. Creëer het bovenstaande model in geometrie. Het materiaal van elk deel en de brekingsindex worden in volgorde gedefinieerd in het materiaal, en poorten en periodieke voorwaarden worden toegevoegd in het elektromagnetische golf frequentiedomein.
Een Diep Leren Neuraal Netwerk Model Bouwen
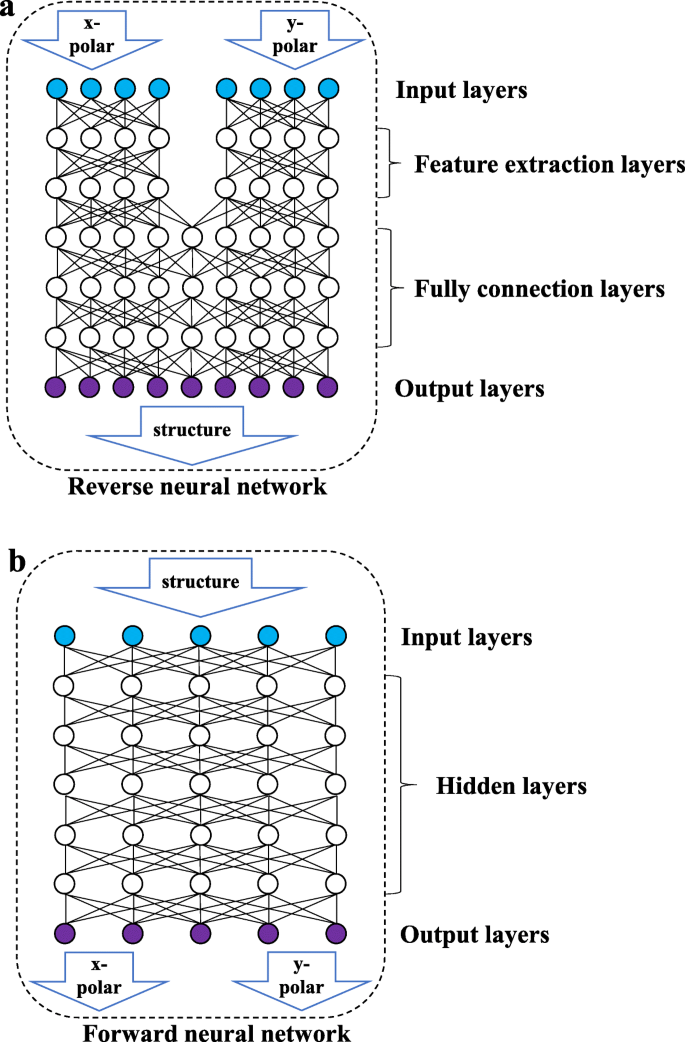
We hebben een omgekeerd netwerk en een voorwaarts netwerk geconstrueerd voor de metamateriaalstructuur. Het omgekeerde netwerk kan de structurele parameters van de SRR voorspellen vanuit de gegeven twee sets golflengte-reflectantiecurves met verschillende polarisatierichtingen. Het voorwaarts netwerk kan de golflengte-reflectantiecurves in twee polarisatierichtingen voorspellen door de gegeven structurele parameters. De functie van het omgekeerde netwerk is de hoofdlijf van de voorspellende functie. De rol van het voorwaarts netwerk is om de voorspellingsresultaten van het omgekeerde netwerk te verifiëren om te observeren of de voorspellingsresultaten voldoen aan de vereiste elektromagnetische respons.
Gebruik Eclipse 2019 als ontwikkelplatform, Python 3.7 als programmeertaal en TensorFlow 1.12.0 als ontwikkelframework.
De twee netwerken apart te trainen om de trainingsresultaten van elk netwerk te bewaren tegen beïnvloeding door de fout van het andere netwerk, wat de respectieve nauwkeurigheid van de twee netwerken garandeert.
Zoals getoond in Fig. 2, is een ander voordeel van het apart trainen van de twee netwerken dat ze voor verschillende doeleinden kunnen worden gebruikt via verschillende verbindingsvolgordes: (a) omgekeerd netwerk + voorwaarts netwerk, wat de gegeven golflengte-reflectantiecurve kan gebruiken om de structurele parameters te berekenen, voorspellingen te maken en te verifiëren of de voorspellingsresultaten aan de behoeften voldoen, en (b) het alleen gebruiken van het voorwaarts netwerk kan het berekeningsproces van de numerieke berekeningsmethode vereenvoudigen en de berekeningstijd reduceren.
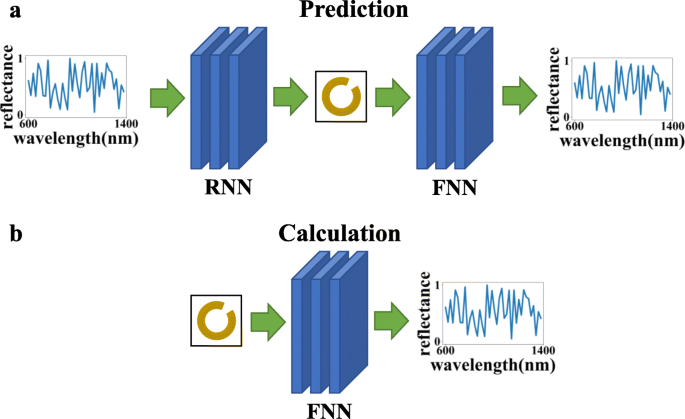
Het is de moeite waard op te merken dat het proces van invoeren en resultaten verkrijgen van het getrainde model met de methode van diep leren extreem korte tijd in beslag neemt. En wanneer ook nieuwe data verkregen wordt door simulatie of experiment, kan het model worden gebruikt voor verdere training. Studies hebben getoond dat met de continue toename van trainingsdata, de nauwkeurigheid van het model steeds hoger wordt en de generalisatieprestaties beter en beter.
De parameters van de structuur zijn meerdere sets continue eigenwaarden, wat behoort tot het regressieprobleem. In de afgelopen jaren zijn volledig verbonden netwerken de focus geweest van diep leren netwerken op regressiekwesties en hebben de kenmerken van hoge betrouwbaarheid, grote datadoorvoer en lage latentie getoond. Enkele aanpassingen aan een volledig verbonden netwerk zullen het netwerk in staat stellen de structuur beter te voorspellen.
Zoals getoond in Fig. 3b, is het voorwaarts netwerk een volledig verbonden netwerk waarin alle knopen van twee aangrenzende lagen met elkaar verbonden zijn. De invoergegevens zijn de structurele parameter, en de uitvoer is de golflengte-reflectantiecurve van de twee polarisatierichtingen. Zoals getoond in Fig. 3a, bestaat het omgekeerde netwerk uit een kenmerkextractielaag (FE-laag) en een volledig verbonden laag (FC-laag). De FE-laag omvat twee sets volledig verbonden netwerken die niet met elkaar verbonden zijn en verwerkt de golflengte-reflectantiecurves van het lineair gepolariseerde licht in de twee richtingen om enkele kenmerken van de invoergegevens te extraheren. De FC-laag zal de geëxtraheerde kenmerken leren en de structurele parameters uitvoeren. Vanwege de kenmerken van hoge cohesie en lage koppeling tussen de golflengte-reflectantiecurves in verschillende polarisatiestaten, kan het scheiden van de invoeren van twee sets gepolariseerde lichtdata in verschillende richtingen voorkomen dat het netwerk wordt gestoord door datastandaardisering tijdens het data-extractieproces. Het voorwaarts netwerk omvat niet meerdere sets invoeren en hoeft geen rekening te houden met wederzijdse interferentie tussen data, dus heeft het geen kenmerkextractielaag.
Om de optimale netwerkstructuur te bepalen, worden netwerken in verschillende structuren getraind met dezelfde dataset. Zoals getoond in Fig. 4, na de data 50 epochs heeft ervaren (wanneer alle data een volledige training heeft ondergaan, noemen we dat een epoch), de MSE bereikt door het voorwaarts netwerk van verschillende structuren. Zoals te zien is uit de linker figuur van Fig. 4, wanneer het voorwaarts netwerk 5 verborgen lagen bevat, elk met 100 knopen, is de laagste bereikte MSE ongeveer 0,0174, dus de voorwaarts netwerkstructuur van deze structuur zal worden geselecteerd.
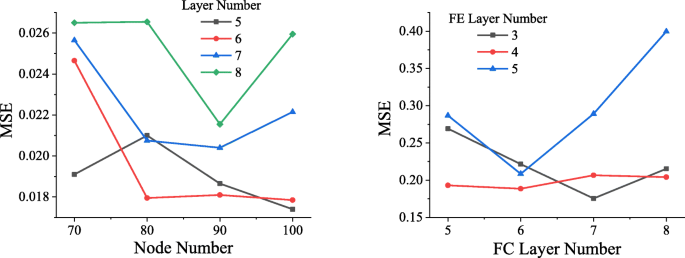
Vergelijkbaar werden verschillende netwerken van omgekeerde netwerken getraind, en het trainingsvolume was nog steeds ingesteld op 50 epochs. Het resultaat wordt getoond in de rechter figuur van Fig. 4. Wanneer het aantal FC-lagen 7 is en het aantal FE-lagen 3, bereikt het netwerk de laagste MSE, wat ongeveer 0,1756 is.
We vonden dat een groter aantal netwerklagen een gradientexplosiefenomeen zal produceren, wat ertoe zal leiden dat het netwerk niet convergeert en de verlies oneindig is, dus wordt het niet in de figuur vermeld.
Datapreprocessing
Om een betrouwbaarder voorwaarts netwerk te trainen, worden de reflectantiegegevens opnieuw verdeeld en aan de brekingsindex van Au en SiO2 die bij elke frequentie hoort, geplakt. De gecollecteerde data wordt genormaliseerd en in het voorwaarts netwerk ingevoerd, wat de nauwkeurigheid van het voorwaarts netwerk aanzienlijk kan verbeteren.
Om te garanderen dat data met grotere waarden geen hogere impact op het netwerk zal hebben dan data met kleinere waarden, moeten de invoergegevens genormaliseerd worden om elke kolom data te laten voldoen aan de standaardnormale verdeling (de gemiddelde waarde is 0, de variantie is 1), en dan kan de verwerkte data x als volgt worden uitgedrukt:
$$ x=\frac{\left({x}_0\hbox{-} \mu \right)}{\sigma } $$ (1)
In de expressie is x0 de oorspronkelijke data van het monster, μ het gemiddelde van het monster, en σ de standaarddeviatie van het monster. Als de invoergegevens niet opnieuw verdeeld worden, zal de reflectantie na normalisatie vervormd raken, wat de nauwkeurigheid van het netwerk zal verminderen. De opnieuw verdeelde data zal zijn verdeling niet beïnvloeden door normalisatie.
Neuraal Netwerk Methode
Het principe van het neuraal netwerk is om veel neuronen (knopen) te bouwen door de manier na te bootsen waarop de menselijke hersenen werken en leren. Neuronen zijn met elkaar verbonden, en de uitvoer wordt aangepast door het aanpassen van de verbindingsgewichten. De uitvoer van de j-de knoop van een laag kan als volgt worden uitgedrukt:
$$ {y}_j=\frac{\sum \limits_{i=1}^nf\left({w}_i{x}_i+{b}_j\right)}{n} $$ (2)
Waarbij f de activeringsfunctie is, wi het verbindingsgewicht van de i-de knoop van de vorige laag verbonden met de j-de knoop, xi de uitvoer van de i-de knoop van de vorige laag, bj de bias-term van deze knoop, en n het aantal knopen in de vorige laag verbonden met de j-de knoop.
Keuze van een Activeringsfunctie
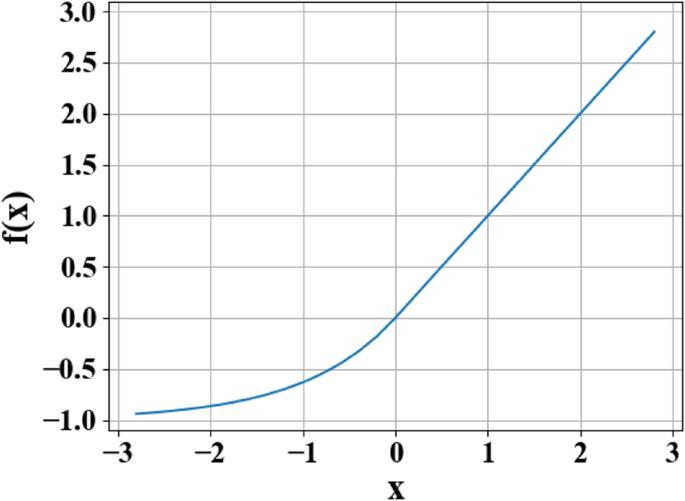
Om aan de hoge niet-lineariteit van het inverse probleem te voldoen, wordt de ELU-functie gebruikt als de activeringsfunctie van elke laag neuronen. De uitvoer f(x) van de ELU-functie kan als volgt in stuksgewijze vorm worden uitgedrukt:
$$ f(x)=\left\{\begin{array}{c}x\\ {}\alpha \left({e}^x-1\right)\end{array}\right.{\displaystyle \begin{array}{c},\\ {},\end{array}}{\displaystyle \begin{array}{c}x\ge 0\\ {}x<0\end{array}} $$ (3)
In deze functie is x de oorspronkelijke invoer, en de parameterwaarde voor α varieert van 0 tot 1.
De reden voor het gebruik van de activeringsfunctie is dat de activeringsfunctie de niet-lineaire expressiemogelijkheid van elke laag van het netwerk verandert, waardoor de algehele niet-lineaire aanpassingsmogelijkheid van het netwerk verbetert. Zoals getoond in Fig. 5, combineert de ELU-functie de voordelen van Sigmoid en gerectificeerde lineaire eenheid (ReLU) activeringsfuncties. Als x < 0, heeft het betere zachte verzadiging, wat het netwerk robuuster maakt tegen invoerwijzigingen en ruis. Als x > 0, is er geen verzadiging, wat helpt om het verdwijnen van de gradiënt van het netwerk te verlichten. Het kenmerk dat de gemiddelde waarde van ELU dicht bij 1 ligt, kan het netwerk makkelijker laten passen. Het resultaat bewijst dat het gebruik van ELU als activeringsfunctie van het diep leren neuraal netwerk de robuustheid van het netwerk aanzienlijk verbetert.
Gewichtsinitialisatieschema
De initialisatiemethode van het netwerkgewicht van elke laag bepaalt de snelheid van het netwerkfitten en bepaalt zelfs of het netwerk kan fitten of niet. Variantieschalinginitialisatie is gebaseerd op de hoeveelheid invoergegevens op elke laag en haalt gewichten op uit een afgeknotte normale verdeling gecentreerd op 0, zodat de variantie kan worden gereduceerd tot een bepaald bereik, zodat de data dieper door het netwerk kan worden verspreid. Op deze netwerkstructuur kan het gebruik van variantieschalinginitialisatie de convergentiesnelheid van het netwerk aanzienlijk versnellen.
Overfitting Oplossing
Vanwege onvoldoende data zal het netwerk enige overfitting produceren. Met gereduceerde overfitting kan het netwerk goede generalisatieprestaties hebben op data buiten de trainingsset. L2-regularisatie (ook gewichtsaftakeling genoemd in regressieproblemen) wordt gebruikt om het gewicht w te verwerken. De geregulariseerde uitvoer L kan als volgt worden uitgedrukt:
$$ L={L}_0+\frac{\lambda }{2n}\sum {w}^2 $$ (4)
In Vergelijking (4) vertegenwoordigt L0 de oorspronkelijke verliesfunctie, en op deze basis wordt een regularisatieterm \( \frac{\lambda }{2n}\sum {w}^2 \) toegevoegd, waar λ de regularisatiecoëfficiënt vertegenwoordigt, n de datadoorvoer, en w het gewicht. Na toevoeging van de regularisatieterm neigt de waarde van het gewicht w over het algemeen af, en het voorkomen van excessieve waarden kan worden vermeden, dus w wordt ook gewichtsaftakeling genoemd. L2-regularisatie kan het gewicht reduceren om een grote helling van de gefitte curve te vermijden, daarmee het overfitting-fenomeen van het netwerk effectief verlichten en helpen convergeren.
Op deze basis wordt ook de dropout-methode gebruikt. Deze methode kan visueel worden beschouwd als "verbergen" van een bepaalde schaal van netwerkknoopen voor elke training, en verschillende knopen verbergen tijdens elke training, om het doel te bereiken van het trainen van meerdere "gedeeltelijke netwerken". En door training kunnen de meeste "gedeeltelijke netwerken" de doelen nauwkeurig vertegenwoordigen, en de resultaten van alle "gedeeltelijke netwerken" kunnen worden gesorteerd om de oplossing van de doelen te verkrijgen.
Het gebruik van de bovengenoemde L2-regularisatie- en dropout-methoden kan niet alleen effectief de lage generalisatie veroorzaakt door onvoldoende data verlichten, maar ook de impact van een kleine hoeveelheid foutieve data in de dataset op de trainingsresultaten reduceren.
Op deze netwerkstructuur en dataset, met dropout = 0,2 en L2-regularisatiecoëfficiënt λ = 0,0001, kan het netwerk vergelijkbare nauwkeurigheid verkrijgen op de trainingsset en testset, waardoor een hoge generalisatieprestatie bereikt wordt.
Resultaat en Discussie
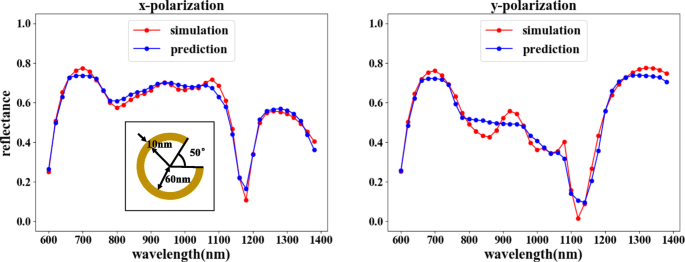
Na training kan ons voorwaarts netwerk een hoge graad van fitting bereiken, met een MSE van 0,0015, wat aantoont dat de uitvoer zeer vergelijkbaar is met de simulateresultaten, zoals getoond in Fig. 6. Dit zorgt er ook voor dat bij het trainen van het omgekeerde netwerk, de resultaten van het omgekeerde netwerk betrouwbaar geverifieerd kunnen worden.
Ten slotte zullen we twee modellen genereren uit het geleerde netwerk en de twee modellen verbinden om de voorspellingsfunctie te bereiken.
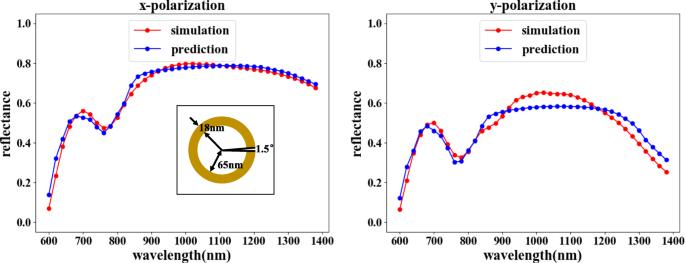
De voorspellingsfunctie kan de combinatie kiezen getoond in Fig. 2a. Het omgekeerde netwerk voorspelt de corresponderende structuur volgens de vereiste golflengte-reflectantiecurve, en het voorwaarts netwerk verifieert de optische respons van de structuur. Zoals getoond in Fig. 7, door de geverifieerde reflectantie te vergelijken met de invoerreflectantie, zijn de reflectantiekenmerken van het invallicht in de twee polarisatierichtingen in wezen consistent. Hoewel kleine reflectantiemismatches observeerbaar zijn voor bepaalde golflengtewaarden, is de algehele matching-trend duidelijk onweerlegbaar, aangezien de fouten goed binnen een acceptabel bereik liggen.
Conclusie
In dit artikel hebben we ons ontworpen diep leren netwerk gepresenteerd, capabel om verschillende effecten te creëren door middel van flexibele combinaties van netwerkconfiguraties. Ons omgekeerde netwerk ontworpen kan de vereiste structuur voorspellen met de invoer golflengte-brekkingscurve, wat de benodigde tijd voor het oplossen van het omgekeerde probleem aanzienlijk kan reduceren en verschillende behoeften kan vervullen door middel van flexibele combinaties. De resultaten wijzen erop dat het netwerk een hogere nauwkeurigheid in voorspellingen heeft bereikt, wat verder impliceert dat op-verzoek ontwerp kan worden opgelost door onze methode. Het gebruik van diep leren om het ontwerp van metamaterialen te begeleiden kan automatisch nauwkeurigere metamateriaalstructuren verkrijgen, een resultaat onbereikbaar door traditionele ontwerpmethoden.
Beschikbaarheid van Data en Materialen
De datum waarop het manuscript afkomstig is van ons simulatie netwerk, en we kunnen het niet delen vanwege sommige persoonlijke redenen.
Afkortingen
- ELU:
- Exponentiële lineaire eenheden
- FC-laag:
- Volledig verbonden laag
- FE-laag:
- Kenmerkextractielaag
- FNN:
- Voorwaarts neuraal netwerk
- MSE:
- Gemiddelde kwadraatsfouten
- ReLU:
- Gerectificeerde lineaire eenheid
- RNN:
- Omgekeerd neuraal netwerk
- SRR:
- Split-ring resonator
Nanomaterialen
- Bouw een Raspberry Pi Cijferherkenner met TensorFlow en OpenCV
- Visie-gebaseerde Obstakel-Vermijdende Mobiele Robot op Raspberry Pi
- TI onthult eerste automotive SoC met toegewezen AI-accelerator
- Nauwkeurige Batterij Levensduur Voorspelling met AI – DOE Argonne Studie
- Deep Learning Versnellen met FPGA's: Snelheid, Flexibiliteit en Energie-efficiëntie
- Activa betrouwbaarheid verhogen: Machine Learning inzetten voor proactieve asset performance
- Wireless Network Devices en Sigfox smeden landelijk UK IoT-netwerk
- Java's split() Methode Beheersen: Een Praktische Gids met Codevoorbeelden
- IBM's Faseveranderende Kunstmatige Neuronen Napen Hersenspikes voor Ultra-Dichte, Laag-Vermogen Computing
- Synergistische elektrische verbetering in epoxy composieten met koolstofnanobuizen en grafiet nanoplatelets
- Monodisperse koolstof nanospheren met hiërarchische porositeit leveren superieure supercondensatorprestaties