



Een Variational Autoencoder Bouwen met TensorFlow: Een Praktische Gids
De fundamenten van autoencoders onder de knie krijgen, ontdekken hoe variational autoencoders ze verbeteren, en doorlopen van een stap‑voor‑stap TensorFlow-implementatie.
Kunstmatige intelligentie heeft talloze sectoren herschapen, en datacompressie is geen uitzondering. Autoencoders – met name hun variatie-varianten – bieden krachtige, generatieve compressieschema's die zowel efficiënt als expressief zijn. Deze gids ontbreekt de kernconcepten en leidt u door een volledige TensorFlow-implementatie met behulp van de MNIST-dataset.
Autoencoder-toepassingen
Autoencoders worden wijd geadopteerd in velden variërend van neurale machinetranslatie tot geneesmiddelontdekking, imagedenoising, en anomaliedetectie. Hun vermogen om gecomprimeerde, informatieve representaties te leren, maakt ze een go‑to tool voor moderne ML-pijplijnen.
Kerncomponenten van een Autoencoder
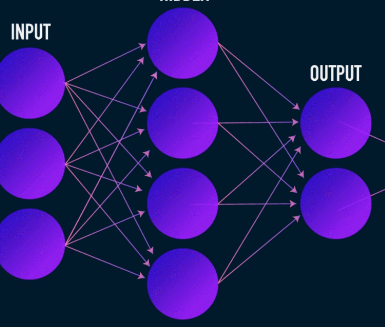
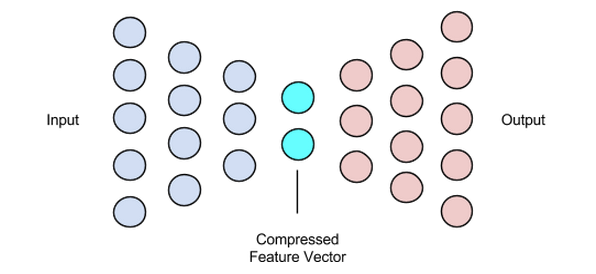
In tegenstelling tot typische neurale netwerken, hebben autoencoders een bottleneck die een laag‑dimensionele latente representatie afdwingt. De architectuur bestaat uit drie primaire delen:
- Encoder – comprimeert invoerdata naar een latente vector.
- Bottleneck (Latente Vector) – slaat de meest kenmerkende features op.
- Decoder – reconstrueert de invoer uit de latente vector.
De encoder en decoder zijn meestal feed‑forward-netwerken, maar gespecialiseerde varianten – convolutioneel voor afbeeldingen, recurrent voor tekst – zijn in de praktijk gebruikelijk.
Encoder
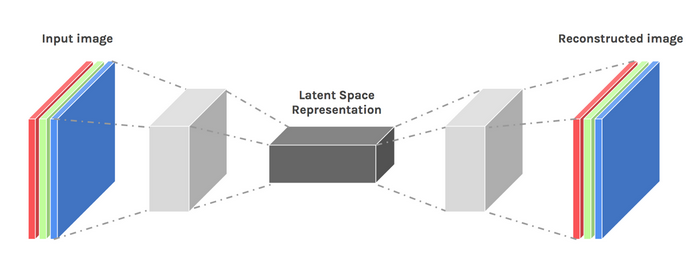
De encoder afficheert hoog‑dimensionale invoeren (bijv. 28×28 pixel afbeeldingen) naar een compacte latente vector. Tijdens training optimaliseert het zijn gewichten zodat de latente vector essentiële informatie vastlegt, wat de decoder in staat stelt de invoer met minimale verlies te reconstrueren.
Bottleneck (Latente Vector)
De latente vector-grootte is een afweging: te klein en u verliest cruciale details; te groot en u ondermijnt compressie en verhoogt berekening. Het selecteren van een geschikte dimensionaliteit is cruciaal voor modelprestaties.
Decoder
De decoder is een spiegelbeeld van de encoder, die de latente vector terug transformeert in de oorspronkelijke dataspace. Het gebruikt typisch getransponeerde convoluties of upsampling-lagen om ruimtelijke resolutie te herstellen.
Autoencoders Trainen
Autoencoders worden end‑to‑end getraind met gradient-gebaseerde optimizers zoals Adam. Het doel is om een reconstructieverlies te minimaliseren dat de discrepantie tussen de invoer en haar reconstructie kwantificeert.
Verliesfuncties
Veelvoorkomende keuzes zijn L1, L2, en mean squared error (MSE). Elk meet hoe dicht de uitgang bij de invoer ligt, wat ze geschikt maakt voor generatieve reconstructietaken.
Netwerkvarianten
Terwijl multi‑layer perceptrons (MLP's) als encoders/decoders kunnen dienen, worden convolutionele neurale netwerken (CNN's) voor afbeeldingsdata prefered vanwege hun ruimtelijke bewustzijn. Recurrente netwerken blinken met sequentiële data zoals tekst.
Standaard autoencoders missen creativiteit – ze kunnen alleen data reproduceren die tijdens training gezien is. Het introduceren van stochasticiteit via een variatief framework ontgrendelt generatieve mogelijkheden.
Variational Autoencoders (VAEs)
VAEs wijzigen de standaardarchitectuur op twee manieren:
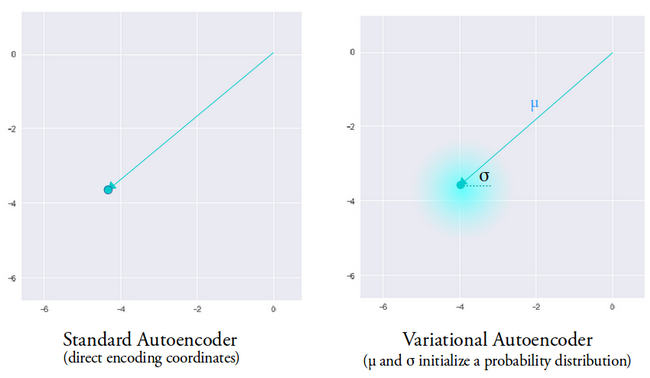
- De encoder outputs een gemiddelde-vector en een variantie-vector, wat een Gaussiaanse verdeling definieert.
- Een Kullback‑Leibler (KL) divergentie-term wordt aan de loss toegevoegd om de latente verdeling te regulariseren naar een eenheids-Gaussiaanse.
Tijdens inferentie samplet de encoder een latente vector uit de geleerde verdeling, wat de decoder in staat stelt diverse, realistische reconstructies te genereren. Deze stochasticiteit mitigeert de discontinuiteten die vaak waargenomen worden in deterministische autoencoders.
TensorFlow Implementatie
Hieronder is een beknopte, productie‑klare TensorFlow-implementatie van een convolutionele VAE getraind op MNIST.
Data Voorbereiding
(train_images, _), (test_images, _) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape(-1, 28, 28, 1).astype('float32')
test_images = test_images.reshape(-1, 28, 28, 1).astype('float32')
train_images /= 255.
test_images /= 255.
train_images[train_images >= .5] = 1.
train_images[train_images < .5] = 0.
test_images[test_images >= .5] = 1.
test_images[test_images < .5] = 0.
TRAIN_BUF = 60000
BATCH_SIZE = 100
TEST_BUF = 10000
train_dataset = tf.data.Dataset.from_tensor_slices(train_images).shuffle(TRAIN_BUF).batch(BATCH_SIZE)
test_dataset = tf.data.Dataset.from_tensor_slices(test_images).shuffle(TEST_BUF).batch(BATCH_SIZE)
VAE Model Definitie
class CVAE(tf.keras.Model):
    def __init__(self, latent_dim):
        super(CVAE, self).__init__()
        self.latent_dim = latent_dim
        self.inference_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(28, 28, 1)),
            tf.keras.layers.Conv2D(32, 3, strides=2, activation='relu'),
            tf.keras.layers.Conv2D(64, 3, strides=2, activation='relu'),
            tf.keras.layers.Flatten(),
            tf.keras.layers.Dense(latent_dim + latent_dim), # mean & logvar
        ])
        self.generative_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(latent_dim,)),
            tf.keras.layers.Dense(7*7*32, activation='relu'),
            tf.keras.layers.Reshape((7, 7, 32)),
            tf.keras.layers.Conv2DTranspose(64, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(32, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(1, 3, padding='SAME'), # logits
        ])

    @tf.function
    def sample(self, eps=None):
        if eps is None:
            eps = tf.random.normal(shape=(100, self.latent_dim))
        return self.decode(eps, apply_sigmoid=True)

    def encode(self, x):
        mean, logvar = tf.split(self.inference_net(x), num_or_size_splits=2, axis=1)
        return mean, logvar

    def reparameterize(self, mean, logvar):
        eps = tf.random.normal(shape=mean.shape)
        return eps * tf.exp(logvar * .5) + mean

    def decode(self, z, apply_sigmoid=False):
        logits = self.generative_net(z)
        if apply_sigmoid:
            return tf.sigmoid(logits)
        return logits
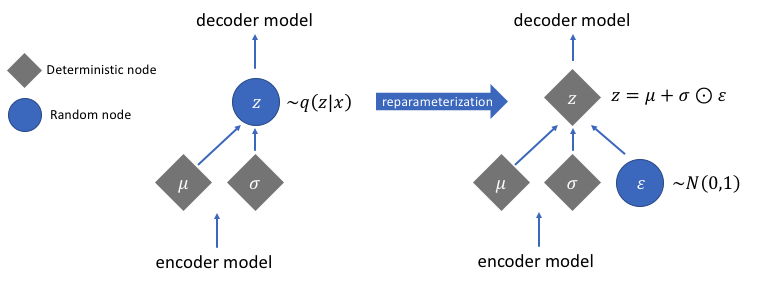
Kern helper-functies – encode, reparameterize, en decode – encapsuleren de VAE-workflow. De reparameterize methode implementeert de reparameterization trick, wat gradient-stroom door stochastic sampling mogelijk maakt.
Reparameterization Trick
Het samplen van een latente vector direct uit een verdeling breekt differentieerbaarheid. Door de sample uit te drukken als z = mean + std * eps waar eps ~ N(0,1), propageren gradienten door mean en std. De KL-divergentie-term wijst de geleerde verdeling verder uit met een standaard-normale, wat gladde latente ruimtes bevordert.
Snelle Samenvatting van Stappen
- Encoder- en decoder-architecturen definiëren.
- De reparameterization trick implementeren om back‑propagation mogelijk te maken.
- Het model end‑to‑end trainen, reconstructieverlies plus KL-divergentie minimaliserend.
Voor de volledige code en aanvullende trainingscripts, bezoek de officiële TensorFlow-tutorial.
Afbeeldingscredit: Chiman Kwan (gewijzigd)
Industriële robot
- AI-gedreven roadmaps: Een strategische gids voor supply chain bedrijven
- Data mining & AI benutten: Industriemerkens blauwdruk om in e-commerce te bloeien
- Gereedschapslevensduur Optimaliseren met Machinedata: Een Moderne Gids
- Afval en energiekosten reduceren met autonoom robots
- CNC-machinetending automatiseren met cobots: efficiëntie en precisie verhogen
- Hoe 3D-Printers Metaalonderdelen Fabriceren: Van Poeder Tot Precisie
- Cloud Technologie Beveiligen: Best Practices Voor Databescherming En Risicomitatie
- Data benutten in het Internet of Reliability: Strategieën voor effectief beheer
- IoT benutten voor HVAC big data: Energie, comfort en luchtkwaliteit optimaliseren – Deel 2
- IoT Tot Leven Brengen Met IBM & Tech Data – Deel 2
- IoT Naar Realiteit Omzetten: Tech Data & IBM Inzichten – Deel 1