



Lokale Minima in Neuraal Netwerk Training: Myth of Realiteit?
De rol van lokale minima bij het trainen van perceptronen en multicouche neurale netwerken begrijpen
In de AAC-reeks over neurale netwerken hebben we al veel aspecten van het ontwerp en de training van multicouche perceptronen behandeld. Voordat we ingaan op lokale minima, is het nuttig de eerdere artikelen te herzien:
- Hoe classificatie uit te voeren met een neuraal netwerk: Wat is de Perceptron?
- Hoe een simpele Perceptron-neuraal netwerk voorbeeld te gebruiken om data te classificeren
- Hoe een basale Perceptron-neuraal netwerk te trainen
- Eenvoudige neuraal netwerk training begrijpen
- Inleiding tot trainings theorie voor neurale netwerken
- Leer snelheid in neurale netwerken begrijpen
- Geavanceerde machine learning met de Multilayer Perceptron
- De Sigmoid-activeringsfunctie: Activering in Multilayer Perceptron neurale netwerken
- Hoe een Multilayer Perceptron neuraal netwerk te trainen
- Trainingsformules en Backpropagation voor Multilayer Perceptrons begrijpen
- Neuraal netwerk architectuur voor een Python-implementatie
- Hoe een Multilayer Perceptron neuraal netwerk in Python te maken
- Signaalverwerking met neurale netwerken: Validatie in neuraal netwerk ontwerp
- Trainingsdatasets voor neurale netwerken: Hoe een Python neuraal netwerk te trainen en valideren
- Hoeveel verborgen lagen en verborgen knooppunten heeft een neuraal netwerk nodig?
- Hoe de nauwkeurigheid van een verborgen laag neuraal netwerk te verhogen
- Bias-knooppunten in je neuraal netwerk integreren
- Lokale minima in neurale netwerk training begrijpen
Het trainen van een neuraal netwerk is een complexe optimalisatietaak. Hoewel we zelden elke wiskundige nuance hoeven te begrijpen om effectieve modellen te bouwen, blijft het fenomeen van lokale minima een cruciale theoretische overweging.
Waarom lokale minima belangrijk zijn
Historisch werden lokale minima gezien als een groot obstakel voor training, met name voor complexe input-output-afbeeldingen. Recent onderzoek – zoals studies naar de geometrie van verliesoppervlakken (bijv. Choromanska et al., 2015; Dauphin et al., 2014) – suggereert dat moderne architecturen en training heuristieken de ernst van dit probleem verminderen. Toch helpt het begrijpen van lokale minima ons te waarderen hoe gradiënt-gebaseerde optimalisatoren navigeren door hoogdimensionale verlieslandschappen en waarom bepaalde trainingstrategieën suboptimale punten kunnen ontlopen.
Een lokaal minimum definiëren
Beschouw een eenvoudig kwadratisch foutoppervlak: f(x, y) = x² + y². Elk punt dat de laagst mogelijke fout oplevert – de globale minimum – is het doel van training. In een perfect convexe kom zal gradiëntdal altijd convergeren naar dit punt, ongeacht de startpositie.
In de praktijk zijn verliesoppervlakken verre van conveks. Ze kunnen meerdere dalen en plateaus bevatten, zoals geïllustreerd hieronder:
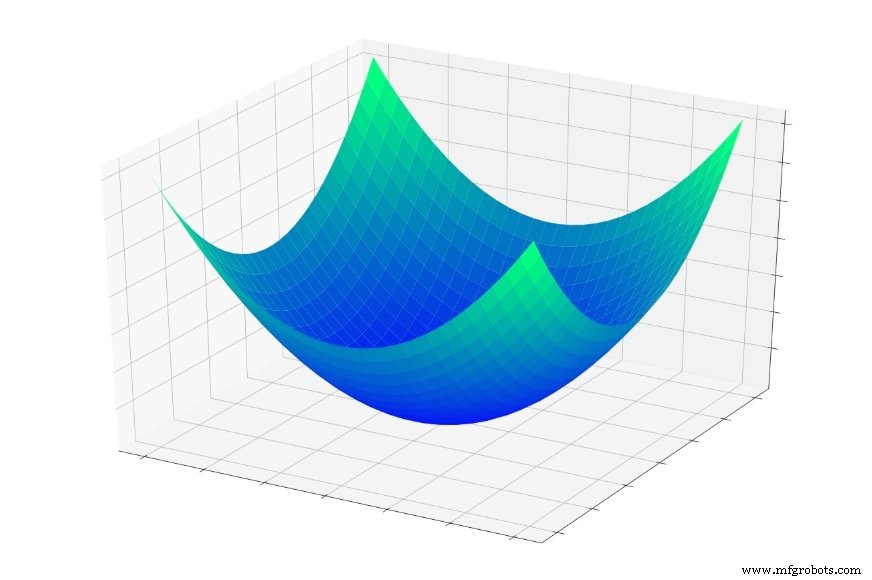
Wanneer de optimalisator in een ondiep bekken stapt, kan het vastlopen in een lokaal minimum – het laagste punt binnen die lokale regio – maar niet de globale. Zonder globale kennis kan het algoritme niet "opklimmen" om diepere dalen te verkennen.
Hebben we de globale minimum echt nodig?
Hoewel het bereiken van de globale minimum vaak correleert met lagere trainingsfout, is het niet altijd synoniem met betere generalisatie. Hooguitdrukkende netwerken die een perfecte fit op trainingsdata bereiken, kunnen overfitten, wat de prestaties op onziene monsters vermindert. In dergelijke gevallen kan een goed gelegen lokaal minimum een robuustere oplossing bieden. Bovendien kunnen zadelpunten – platte regio's waar gradiënten in sommige richtingen verdwijnen – een grotere uitdaging vormen dan eenvoudige lokale minima (Goodfellow et al., 2015).
Praktische implicaties
Moderne trainingpraktijken verlichten de effecten van lokale minima door technieken als stochastische gradiëntdal, leersnelheidsschema's, momentum, de Adam-optimalisator en gewichtsinitialisatieschema's. Ensemble-methoden en regularisatie (dropout, L2) helpen het model ook om overfitting op de globale minimum te voorkomen.
Conclusie
Lokale minima blijven een fascinerend aspect van neuraal netwerk training. Hun impact te begrijpen informeert de keuze van architectuur, optimalisator en regularisatiestrategie. In het volgende artikel zullen we concrete technieken verkennen – zoals leersnelheidsannealing en adaptieve optimalisatoren – die netwerken sturen naar wenselijke minima.
Industriële robot
- Netwerktopologieën begrijpen: van point-to-point tot ring en ster
- Netwerkprotocollen begrijpen: van fysieke laag tot geavanceerde arbitrage
- Kunstmatige Neurale Netwerken Verbeteren Draadloze Communicatieprestaties
- Training van groot neuraal netwerk genereert 284.000 kg CO₂ – equivalent aan 5 auto's levensduuruitstoot
- Bias-knooppunten toevoegen aan een Multilayer Perceptron in Python
- Verborgen laag grootte optimaliseren voor betere neuraal netwerk nauwkeurigheid
- Het juiste aantal verborgen lagen en knooppunten kiezen in een neuraal netwerk
- Robot Vezel Lasersnijden vs Plasma Snijden: Belangrijkste Verschillen & De Juiste Keuze Maken
- STMicroelectronics lanceert STM32Cube.AI – edge‑apparaten versterkt met embedded neural networks
- CEVA onthult NeuPro-S: next-gen AI-processor voor edge deep neural network inferentie
- NIST's neurale netwerk detecteert kleine geometrische vormen in dichte beelden met 97% nauwkeurigheid