



Buiten trial and error: een bewezen gids voor effectief onderhoudstroubleshooting
Een uitgebreide bron voor onderhoudsteams die troubleshooting transformeert van haperende fixes in een systematisch, datagestuurd proces dat downtime reduceert en betrouwbaarheid verhoogt.
Inhoudsopgave
- Wat is troubleshooting?
- Strategieën om uw troubleshooting-skills te scherpen
- Onderhoudssoftware benutten voor snellere resolutie
- Kernpunten
In de wereld van onderhoud kan troubleshooting voelen als een kunst – spontaan, intuitief, en vaak onvoorspelbaar. Benaderd met een gestructureerde methodologie, wordt het een precieze wetenschap die probleemresolutie versnelt, verloren productie minimaliseert, en compliance ondersteunt.
Wat is troubleshooting?
Apparatuurstoringen zijn onvermijdelijk, of het nu een transportband, een industriële boor, of een ander kritisch activum is. Troubleshooting is de gedisciplineerde praktijk van het diagnosticeren van een probleem dat niet direct duidelijk is. Het meest effectieve proces volgt een vierstapscyclus: het probleem identificeren, een reactie plannen, de oplossing testen, en resolutie bevestigen. Deze stappen worden herhaald tot de basiscausus geëlimineerd is.
Het probleem identificeren
Een reactie plannen
De oplossing testen
Herhalen tot opgelost
Bijvoorbeeld, wanneer een transportband onverwacht stopt, identificeert een technicus eerst het foutieve component, plant dan een reparatie – misschien lagers heruitlijnen of smering toevoegen – en test de fix. Als het probleem aanhoudt, vervangen ze het onderdeel, wat uiteindelijk de functionaliteit herstelt.
Hoe wordt troubleshooting typisch uitgevoerd in onderhoud?
Vaak wordt een defect activum onderzocht door operators, handleidingreferenties, en historische notities, wat leidt tot een reeks pogingsfixes voordat de technicus afgeleid wordt naar een andere noodzaak. Deze gefragmenteerde benadering – vooral wanneer registraties op papier of in ongestructureerde spreadsheets worden gehouden – creëert vertragingen en verhoogt het risico op misdiagnose.
Waarom is troubleshooting belangrijk in onderhoud?
Onverwachte uitvallen zijn de reden waarom onderhoud bestaat. Hoewel preventieve en conditiegebaseerde strategieën risico reduceren, kunnen ze ongeplande downtime niet elimineren. Robuuste troubleshooting-procedures stellen teams in staat om snel te diagnosticeren, corrigeren, en herhalende issues te voorkomen, wat productiviteit, veiligheid, en regelgevende compliance beschermt.
Menselijke expertise blijft essentieel, maar technologie kan dataverzameling, analyse, en kennisdeling stroomlijnen. Een verfijnde troubleshooting-workflow transformeert downtime in een kans voor continue verbetering in plaats van een kosten-drainende nachtmerrie.
Strategieën om uw troubleshooting-skills te scherpen
Hier zijn praktische stappen die de troubleshooting-capaciteiten van uw team verhogen.
Assetprestaties kwantificeren en de data interpreteren
Diepe bekendheid met de normale werking van een activum is fundamenteel, maar echte meesterwording komt van het analyseren van prestatiemetrics – zoals mean time between failures (MTBF) en overall equipment effectiveness (OEE). Door sensordata te correleren met KPI's, kunnen technici subtiele afwijkingen detecteren die aankomende storingen signaleren.
Best practices voor het tracken en gebruiken van assetdata
Uitsluitend vertrouwen op anekdotische ervaring kan beslissingen scheven naar de meest recente fix, waarbij diepere oorzaken over het hoofd worden gezien. Huidige symptomen kruisrefereren met historische data vermindert recency bias en zorgt ervoor dat oplossingen basiscausussen targeten in plaats van oppervlakkige symptomen.
Uitgebreide assethistorieën creëren
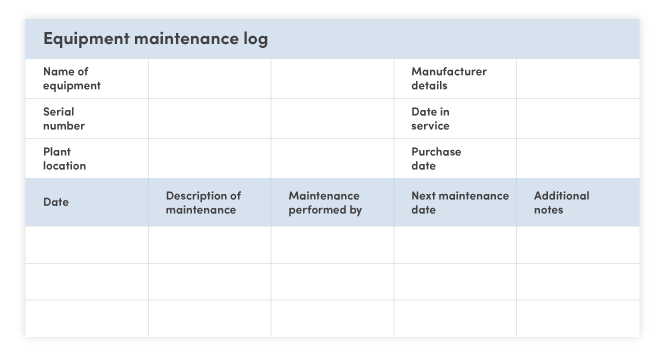
Een goed gedocumenteerde historie is de ruggengraat van efficiënt troubleshooting. Documenteer elke interactie: uitvallen, preventief onderhoud (PM) bezoeken, inspecties, onderdeelvervangingen, productieschema's, en eventuele afwijkende observaties zoals rook of ongewone geluiden. Markeer de succesvolle resolutie, inclusief onderdelen, arbeid, en veiligheidsapparatuur gebruikt.
Gebruik een gestructureerd onderhoudslogboek om deze details vast te leggen. Download onze template.
Root cause analysis (RCA) en falingscodes inzetten
RCA betreft iteratief "waarom" vragen tot het onderliggende issue onthuld is. Bijvoorbeeld:
- Apparatuur faalde omdat een lager uiteengezaagd was.
- Lager uiteengezaagd door verkeerd uitgelijnde koppeling.
- Koppeling verkeerd uitgelijnd omdat het niet geserviced was.
- Onderhoud niet gepland door onduidelijke intervallen.
- Intervallen onduidelijk door onvoldoende data.
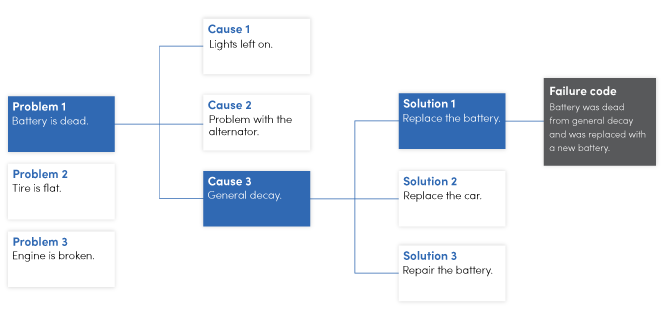
Falingscodes standaardiseren de beschrijving van incidenten. Ze vangen probleemtype, basiscausus, en aanbevolen remedie, wat snelle cross-asset analyse en preventieve actie mogelijk maakt.
Gedetailleerde taaklijsten ontwikkelen
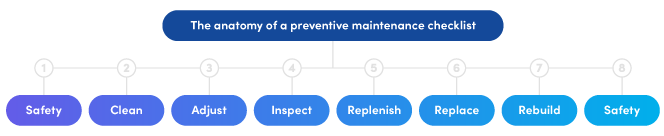
Duidelijke, stap-voor-stap taaklijsten leiden technici door inspecties, reparaties, en PM's, wat de kans op weglating vermindert. Neem alle benodigde materialen, bronnen, en persoonlijke beschermingsmiddelen (PBM) op. Taaklijsten dienen ook als audittrails, wat inzicht biedt in recent werk bij het diagnosticeren van storingen.
Zorgen dat informatie gemakkelijk toegankelijk is
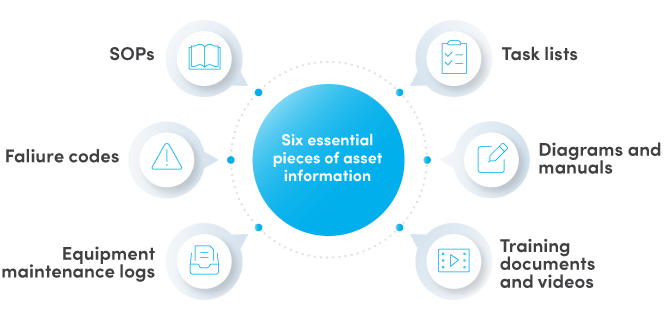
Data, SOPs, diagrammen, trainingvideo's, en handleidingen moeten per activum georganiseerd zijn en gehost op een digitale kennis hub. Mobiel-vriendelijke platforms laten technici kritieke informatie op de werkvloer ophalen, wat de noodzaak elimineert om fysieke bestanden te doorzoeken of te vertrouwen op een enkel individu's geheugen.
Alles wat u moet weten over onderhoudsmetrics
Onderhoudssoftware benutten voor snellere resolutie
Digiplatformen zoals Computerized Maintenance Management Systems (CMMS) centraliseren data, automatiseren workflows, en bieden realtime inzichten. Ze stroomlijnen assethistoriecreatie, falingscodemanagement, en taaklijstuitvoering, wat technici vrijmaakt om zich te richten op analyse in plaats van data-invoer.
Bijvoorbeeld, een CMMS kan technici prompten met een gestructureerde vragenlijst tijdens een storing, notities direct vastleggen, en de entry koppelen aan de assetgeschiedenis. Wanneer een vergelijkbaar issue elders opduikt, laat het systeem relevante eerdere incidenten en aanbevolen oplossingen zien.
Kernpunten
Troubleshooting zal altijd onderdeel zijn van onderhoud. Door systematische benaderingen te adopteren – root cause analysis, falingscodes, gedetailleerde taaklijsten, en digitale kennis hubs – kunt u de afhankelijkheid van trial and error reduceren, reparatietijden verkorten, en de algehele apparatuurbetrouwbaarheid verbeteren.
Onderhoud en reparatie van apparatuur
- Mobiel onderhoud: De cloud-gedreven revolutie in CMMS
- Bovenop tickets: Hoe Fiix' werkverzoekportaal Total Productive Maintenance drijft
- Operaties & Onderhoud Transformeren: Een Praktische Gids voor Effectieve Planning
- Lean Machines voor Wereldklasse Productie en Onderhoud: Een Praktische Gids voor Apparatuursexcellentie
- VS Leger Verbetert Voorwaardelijke Onderhoud met Innovatieve Sensoren en Predictieve Analyse
- Maximaliseren van Onderhoudsproductiviteit door Multiskill-Training
- 5 Bewezen Regels om Operaties & Onderhoud Partnerschap te Versterken
- Naast Onderhoud: Een Holistische Aanpak Om Apparatuurbeschikbaarheid Te Verhogen
- Span of Control en planning optimaliseren voor onderhoudsteams
- Betrouwbaarheid van Krachtoverdracht Componenten Verhogen: Bewezen Strategieën voor Mijnbouw, Productie & Industriële Operaties
- 3 essentiële tips voor succesvolle industriële apparatuurhuren & onderhoud