



Verbeterde documentverwerking: regel-gebaseerde en model-gebaseerde technieken combineren voor nauwkeurige automatisering
Informatie is macht. Voor de meeste bedrijven zit veel waardevolle zakelijke informatie vast in documenten. Gegeven de verscheidenheid aan documenttypen, formaten en groottes die bedrijven vaak beheren, kan het efficiënt verwerken van documenten om inzichten te verkrijgen een uitdaging zijn.
Hier bij UiPath begrijpen we deze uitdaging. Dankzij ons nieuwste document understanding-framework kunnen onze klanten gegevensuitwisseling en -verwerking voor een breed scala aan documenten eenvoudig automatiseren, ongeacht hun type, formaat of volume. Dit helpt je documentverwerking aan te pakken met flexibiliteit, met behulp van welk proces ook het beste werkt voor jouw unieke behoeften.
Voor een hoger niveau kijk op de voordelen van document understanding, bekijk ons white paper Operationele efficiëntie verhogen en risico's verminderen met Document Understanding.
In dit artikel zullen we:
Veelvoorkomende documenttypen en classificaties bekijken
Regel-gebaseerde en model-gebaseerde data-extractiemethoden onderzoeken
Kijken naar de veelvoorkomende uitdagingen die bedrijven tegenkomen bij het toepassen van elk van deze standaardbenaderingen voor documentverwerking
De voordelen bekijken die bedrijven kunnen krijgen als beide documentverwerkingsbenaderingen gecombineerd worden als een multi-approach data-extractiemethode
Laten we beginnen.
Documentenlandschap
Afhankelijk van hun structuur en formaat, kunnen documenten in drie typen geclassificeerd worden.
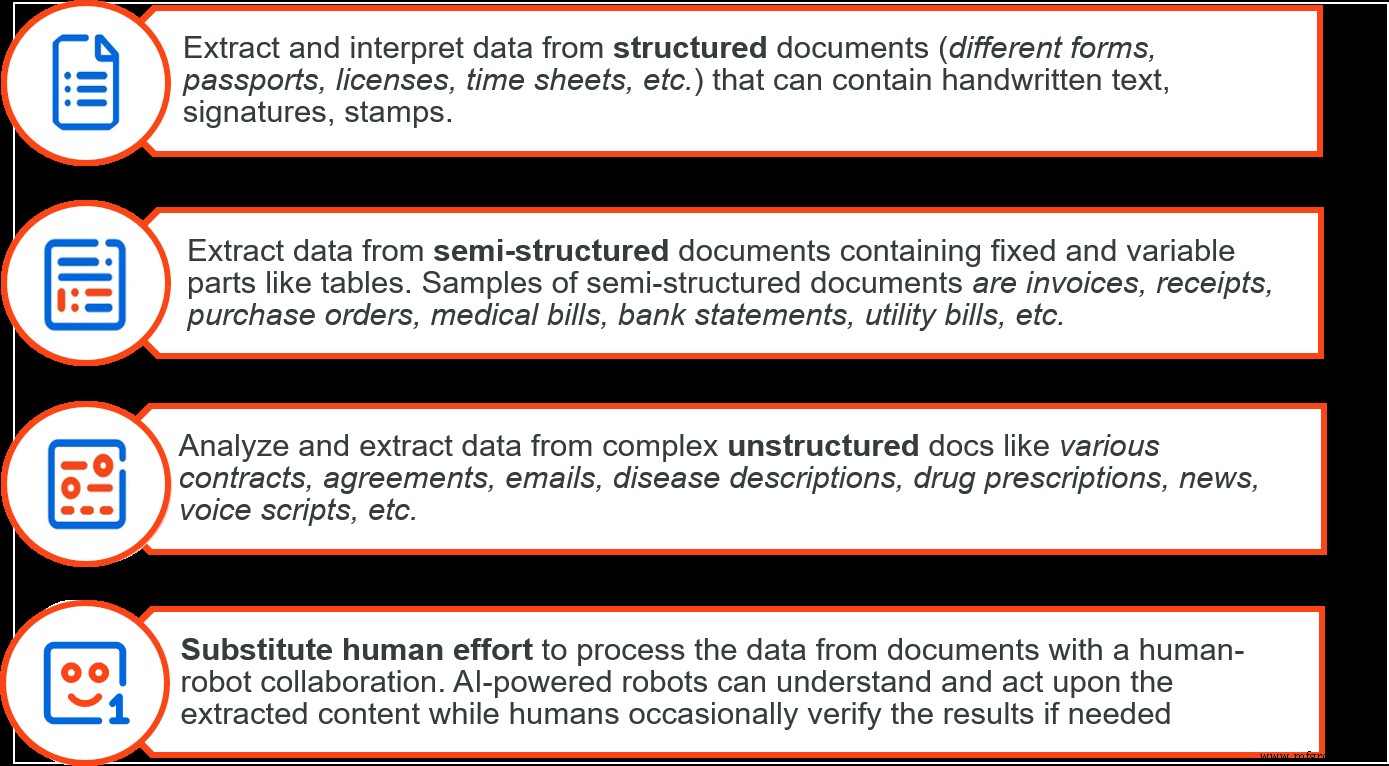
1. Veel documenten, zoals belastingformulieren, blijven vast in formaat – deze heten gestructureerde documenten.
2. Anderen, zoals contracten, hebben geen standaardstructuur – deze worden aangeduid als ongestructureerde documenten.
3. Ten slotte worden documenten die verschillende kenmerken hebben, zoals variërende lay-outs of ontwerpen, maar vergelijkbare typen informatie bevatten, semi-gestructureerde documenten genoemd. Bonnetjes, facturen en inkooporders zijn veelvoorkomende voorbeelden van documenten in deze categorie.
Op basis van de classificatie van documenten, zijn er twee veelvoorkomende typen data-extractiemethodologieën. Regel-gebaseerde data-extractie richt zich op gestructureerde documenten, terwijl model-gebaseerde data-extractie gebruikt wordt om semi-gestructureerde en ongestructureerde documenten te verwerken.
Voordelen en beperkingen van regel-gebaseerde data-extractiemethoden
Regel-gebaseerde data-extractie steunt op een set regels om data uit een document te extraheren. Je kunt bijvoorbeeld documenttemplates maken en regels toepassen op basis van specifieke dataposities. Alternatief, zonder templates te hoeven maken, kun je gewoon regels toepassen op basis van hoe frequent sommige datasets in een document worden gebruikt (voorkomenspatronen) of hoe die datavariabelen er meestal uitzien in een reeks tekens (regular expression of regex).
Het eerste is nuttig bij formulieren die getemplateerd kunnen worden, en het laatste wordt gebruikt als het mogelijk en makkelijk is om dergelijke regels te maken. We zien dat regel-gebaseerde methoden makkelijk in te stellen en te begrijpen zijn, en ze werken zeer efficiënt in documentverwerking. Echter, ze zijn beperkt tot gestructureerde documenten en alleen in een paar eenvoudige gevallen tot semi-gestructureerde documenten.
Dus, hoewel regel-gebaseerde data-extractietechnieken in veel contexten nuttig zijn, hebben ze duidelijke toepassingsbeperkingen. Aangezien template-gebaseerde extractie nauw verbonden is met een vaste documentlay-out, kunnen wijzigingen in de lay-out de regels breken en herconfiguratie van regels vereisen.
Op dezelfde manier kunnen regex-gebaseerde technieken uitdagend zijn om te implementeren, troubleshooten en omslachtig worden naarmate situaties complexer worden. Echter, er is een alternatieve benadering voor regel-gebaseerde extractieoplossingen – een model-gebaseerde benadering.
Voordelen en beperkingen van model-gebaseerde data-extractiemethoden
Model-gebaseerde data-extractiemethodologieën zijn gebaseerd op machine learning (ML). Deze methoden zijn krachtig dankzij hun vermogen om te leren van een diverse set documenten. We gebruiken deze methoden door gesofisticeerde technieken in te zetten zoals natural language processing (NLP) en statistisch leren.
De UiPath Validation Station voorziet gebruikers van een human-in-the-loop mogelijkheid, zodat modellen on-the-fly kunnen leren en zich aanpassen aan veranderingen in de data. Kunstmatige intelligentie (AI)-aangedreven technologie wordt typisch gebruikt voor data-extractie uit semi-gestructureerde en ongestructureerde documenten. We hebben bijvoorbeeld ML-modellen gemaakt voor gebruik in ons document understanding-framework om scenario's als bonnetje- en factuurverwerking aan te pakken.
Lees meer: AI gebruiken om factuur- en bonnetjeverwerking te automatiseren
De uitdaging van het gebruik van model-gebaseerde extractietechnieken is de tijd en expertise die ze kunnen kosten om ML-modellen te creëren en te implementeren. In veel scenario's zijn model-gebaseerde technieken echter superieur in hun vermogen om te leren en zich aan te passen aan verschillende documentstructuren en inclusies.
Multi-approach data-extractie omarmen
Er is geen zilveren kogel om alle documentverwerkingsbehoeften aan te pakken. Zowel regel-gebaseerde als model-gebaseerde benaderingen voor data-extractie zijn krachtige tools, maar beperkt in hun vermogen om het bereik van documenten die bedrijven beheren optimaal te verwerken.
Sommige gestructureerde documenten hebben veel meer nodig dan alleen regel-gebaseerde methodologieën, aangezien sommige data niet geëxtraheerd kan worden met de hulp van regels of templates. Evenzo werken puur model-gebaseerde methoden niet voor alle ongestructureerde en semi-gestructureerde documenten.
We willen dat gebruikers gemakkelijk verschillende benaderingen kunnen combineren om informatie uit een enkel document te extraheren. Daarom hebben we ons document understanding-framework ontworpen om je de kracht te geven om beperkingen die opgelegd worden door een individuele benadering te overwinnen. We bevelen ten zeerste aan om multi-approach data-extractie te gebruiken wanneer je te maken hebt met gecompliceerde documenten en de hoogste niveaus van nauwkeurigheid tijdens het data-extractieproces wilt bereiken.
Snelle en nauwkeurige multi-approach data-extractie
Met ons flexibele framework kun je documentverwerkingsbenaderingen mixen en matchen door simpelweg meerdere data-extractietechnieken direct in je workflow in UiPath Studio te droppen.
Je kunt eenvoudig extractors configureren voor dataverwerking, voorkeursvolgorde instellen voor extractie-uitvoering, en een waarde instellen als drempelwaarde voor bepaalde extractieresultaten om als geldig geaccepteerd te worden. Op deze manier zal noch variabele documentstructuur noch gecompliceerde regels voor data-extractie een uitdaging meer vormen. Tegelijkertijd, binnen end-to-end automatisering, krijg je snellere en veel nauwkeurigere documentverwerking met de nieuwste AI-technologie.
Geïnteresseerd?
Efficiënte en nauwkeurige documentextractie- en verwerkingsmogelijkheden zijn cruciaal. Door onze nadruk op multi-approach data-extractie willen we documentverwerking en -analyse zo makkelijk mogelijk maken voor UiPath-klanten.
Momenteel zijn uitgebreide Document Understanding-mogelijkheden en -functionaliteit beschikbaar als Software-as-a-Service (SaaS) in een bètaversie voor gebruikers betrokken bij eerdere pilots. Je kunt verwachten dat deze functies en andere geavanceerde Document Understanding-tools binnenkort beschikbaar zullen zijn. Ondertussen moedigen we je aan om je aan te melden voor de UiPath enterprise proefversie om toegang te krijgen tot de UiPath Document Understanding-oplossing.
Automatisering Besturingssysteem
- VS Leger Verbetert Voorwaardelijke Onderhoud met Innovatieve Sensoren en Predictieve Analyse
- Hygiënisch Ontwerp voor Voedings- & Verwerkingsindustrie: Van Reinigbaarheid tot Kostenbesparing
- ABB onthult ultramoderne cloud-automatisering voor datacenters
- Ambarella, Lumentum en ON Semiconductor onthullen AI-gedreven 3D sensing oplossingen voor next-gen AIoT apparaten
- Industrieel IoT & Predictive Analytics: productie-efficiëntie versnellen
- Vlootbeheer revolutioneren: AI & IoT integratie voor slimmere operaties
- Hoe IIoT & Data Analytics EHS transformeren: Veiligheid, efficiëntie en besparingen verhogen
- Hoe Sensor- & Operationele Data Winstgevendheid Drijft Voor Een Leidende Vervoerfabrikant
- Edge AI: Waarom Verwerking naar de Apparaatlaag Verplaatst
- Fog Computing Uitgelegd: IoT Datastroom Transformerend en Cloudbelasting Reducerend
- Industriële AIoT: AI en IoT samensmelten om Industry 4.0-innovatie te drijven