



Analoge in-memory computing: energie-efficiënte edge AI-inferentie
Machine learning en deep learning zijn nu in het alledaagse leven ingeweven. Van natural-language-assistents tot real-time objectdetectie, AI drijft een groeiend aantal consumenten- en industriële apparaten. Toch vertrouwen de meeste van deze toepassingen op cloud-gebaseerde inferentie-engines – een architectuur die zorgen oproept over privacy, stroomverbruik, latentie en kosten.
Het lokaal deployen van AI op de edge kan die problemen elimineren. De hoofduitdaging is het geheugen-gedreven stroomverbruik van conventionele digitale neurale-netwerk-accelerators. Wanneer gewichten en activaties uit DRAM of SRAM opgehaald worden, verbruikt de data-verplaatsing alleen al twee tot drie ordes van grootte meer energie dan de rekenoperaties zelf. Analoge in-memory computing aanpakt deze bottleneck door multiply-accumulate (MAC)-operaties direct binnen een non-volatile geheugenarray uit te voeren.
Cloud-gebaseerde AI: de pijnpunten
Wanneer een edge-apparaat ruwe data naar een externe server stuurt, ontstaan diverse problemen:
- Privacy & beveiliging – Persoonlijke of vertrouwelijke informatie wordt verzonden en opgeslagen in datacenters.
- Onnodig stroomverbruik – Elke bit die over de radio verstuurd, in de cloud opgeslagen en opnieuw opgehaald wordt, verbrandt energie.
- Latentie voor small-batch inferentie – Reacties kunnen meer dan 100ms duren, wat waarneembaar is voor gebruikers.
- Data-economie on 효율성 – Sensoren genereren massive streams; alles uploaden is noch economisch noch duurzaam.
Om deze uitdagingen te overwinnen, wordt een getraind model eerst gebouwd op een high-performance-platform (cloud, GPU-farm, etc.). De resulterende gewichten worden vervolgens gemapt naar een lightweight inferentie-engine die de berekening lokaal uitvoert.
De MAC-zware aard van neurale netwerken
Zelfs lightweight-modellen worden gedomineerd door MAC's. Bijvoorbeeld, MobileNet-v1 met een 224×224-input bevat 4,2 miljoen parameters en vereist 569 miljoen MAC's per inferentie. De vermenigvuldiging en accumulatie worden uitgevoerd in een dense matrix-vector-product.
Waarom digitale computing worstelt
In een conventionele accelerator worden gewichten en activaties opgeslagen in DRAM/SRAM en moeten opgehaald worden in een arithmetic logic unit (ALU). Figuur 3 illustreert de geheugen-bottleneck: de energie besteed aan data-verplaatsing (50–100 pJ per transfer) overschaduwt de 250 fJ per MAC-operatie. Zelfs met agressieve data-hergebruikstechnieken legt de Von Neumann-architectuur een harde limiet op voor power-efficiëntie.
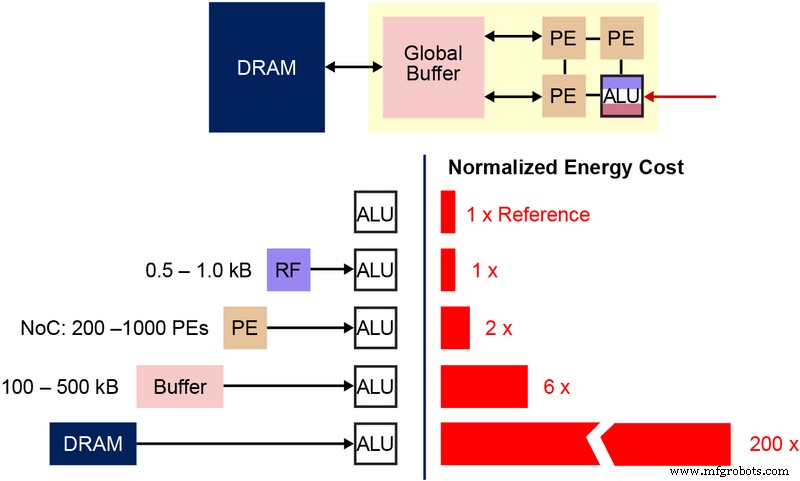 Figuur 3: Geheugen-bottleneck in Machine Learning-berekening. (Bron: Y.-H. Chen, J. Emer, en V. Sze, "Eyeriss: A Spatial Architecture for Energy‑Efficient Dataflow for Convolutional Neural Networks," ISCA, 2016.)
Analoge in-memory computing tot de redding
Door berekening in de geheugenarray zelf in te sluiten, verdwijnt de behoefte om gewichten te shuttelen. De overgebleven data-overdracht is beperkt tot het input-signaal, wat typisch een sensor-output is. Flash-cellen die in het sub-threshold-regime werken, verbruiken sub-nanoamp-stromen, wat actieve power verwaarloosbaar maakt. In standby behouden de non-volatile cellen data zonder enig stroomverbruik.
Het memBrain™-platform van Silicon Storage Technology (een Microchip-bedrijf) verbeeldt deze aanpak. Gebouwd op de SuperFlash® (ESF3)-geheugentechnologie, kan elke bitcel geprogrammeerd worden naar een precieze drempelspanning (Vt), wat een conductance vestigt die een gewicht vertegenwoordigt. Wanneer een input-spanning wordt aangelegd, is de stroom door de cel gelijk aan het product van de input en het opgeslagen gewicht.
Multi-level geheugenarchitectuur
Figuur 4 toont de doorsnede van een ESF3-bitcel. De cel omvat vijf terminalen – Control Gate (CG), Word Line (WL), Erase Gate (EG), Source Line (SL) en Bitline (BL). Hoogspannings-EG programmeert de floating gate, terwijl lage-spannings-biasing op de overige terminalen de cel leest of schrijft.
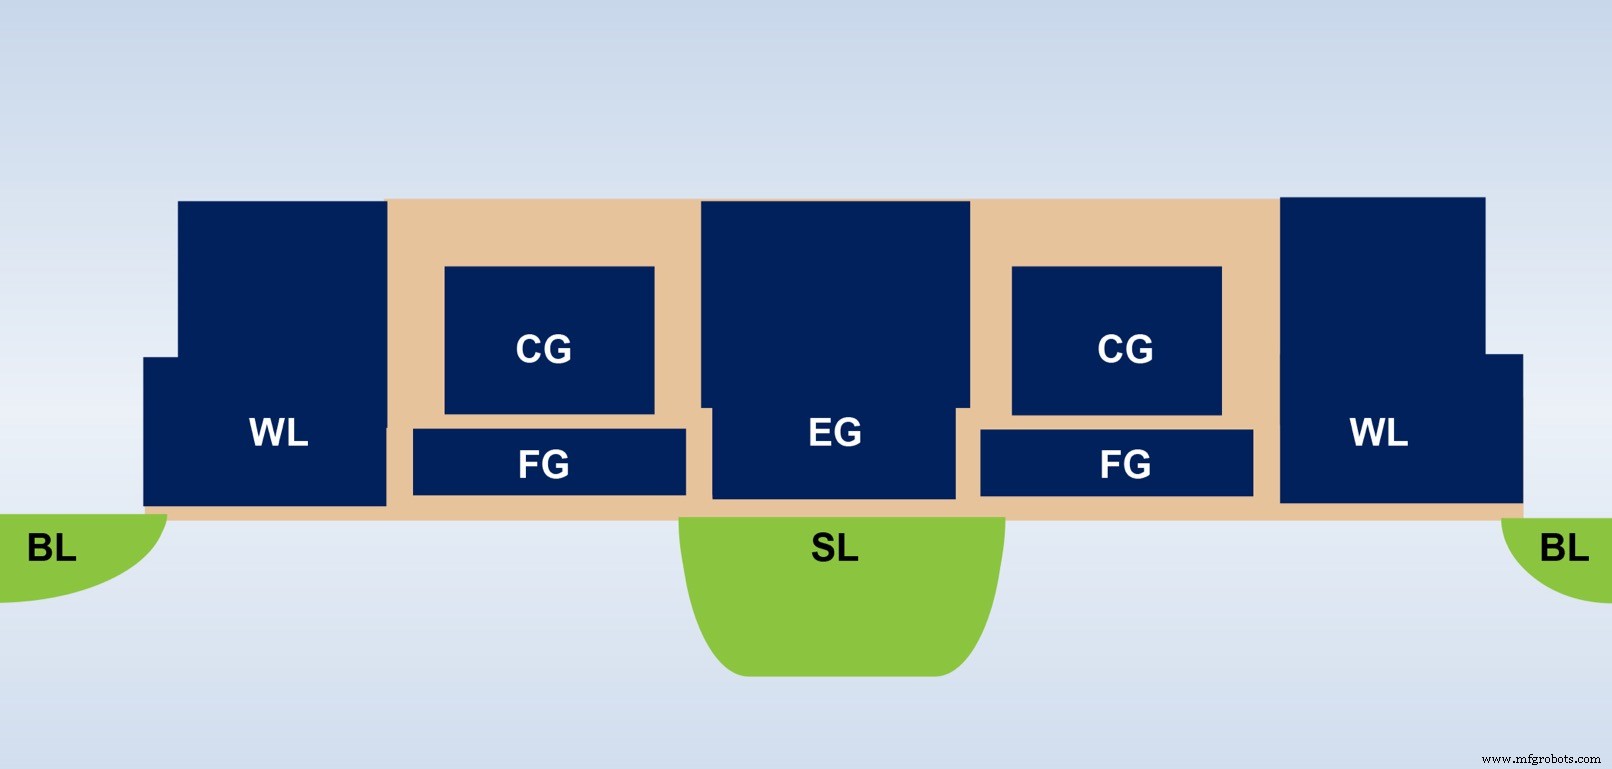 Figuur 4: SuperFlash ESF3-cel. (Bron: Microchip Technology)
Fijnmazige programmering past de floating-gate Vt aan om een specifieke I-V-curve te produceren. Figuur 5 demonstreert een 2-bit-voorbeeld waar vier distincte Vt-niveaus vier afzonderlijke stroomresponsen opleveren wanneer een vaste CG-spanning wordt toegepast.
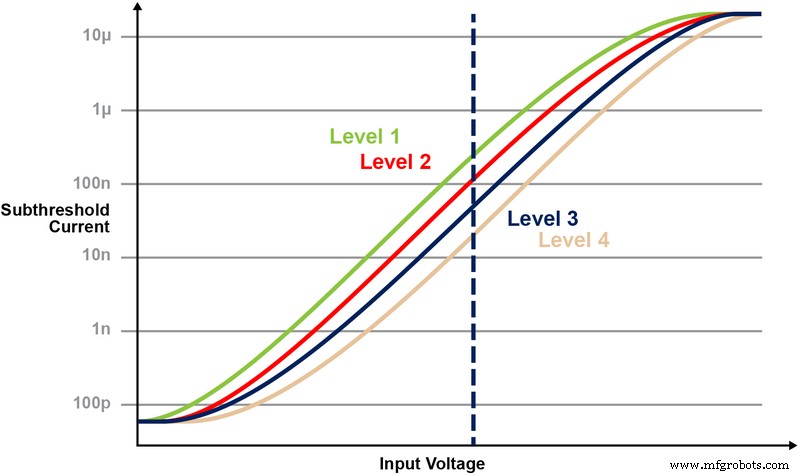 t Levels in ESF3 Cell" /> Figuur 5: Programmeren van Vt-niveaus in ESF3-cel. (Bron: Microchip Technology)
MAC in de geheugenarray
Elke cel's conductance gm vertegenwoordigt een getraind gewicht. De stroom Iout = gm · Vin implementeert de vermenigvuldigingsstap. Door veel cellen parallel te schakelen, tellen de kolomstromen zich natuurlijk op, wat de accumulatoperatie oplevert. Figuur 6 visualiseert een 2×2-array die twee MAC's en één accumulatie uitvoert.
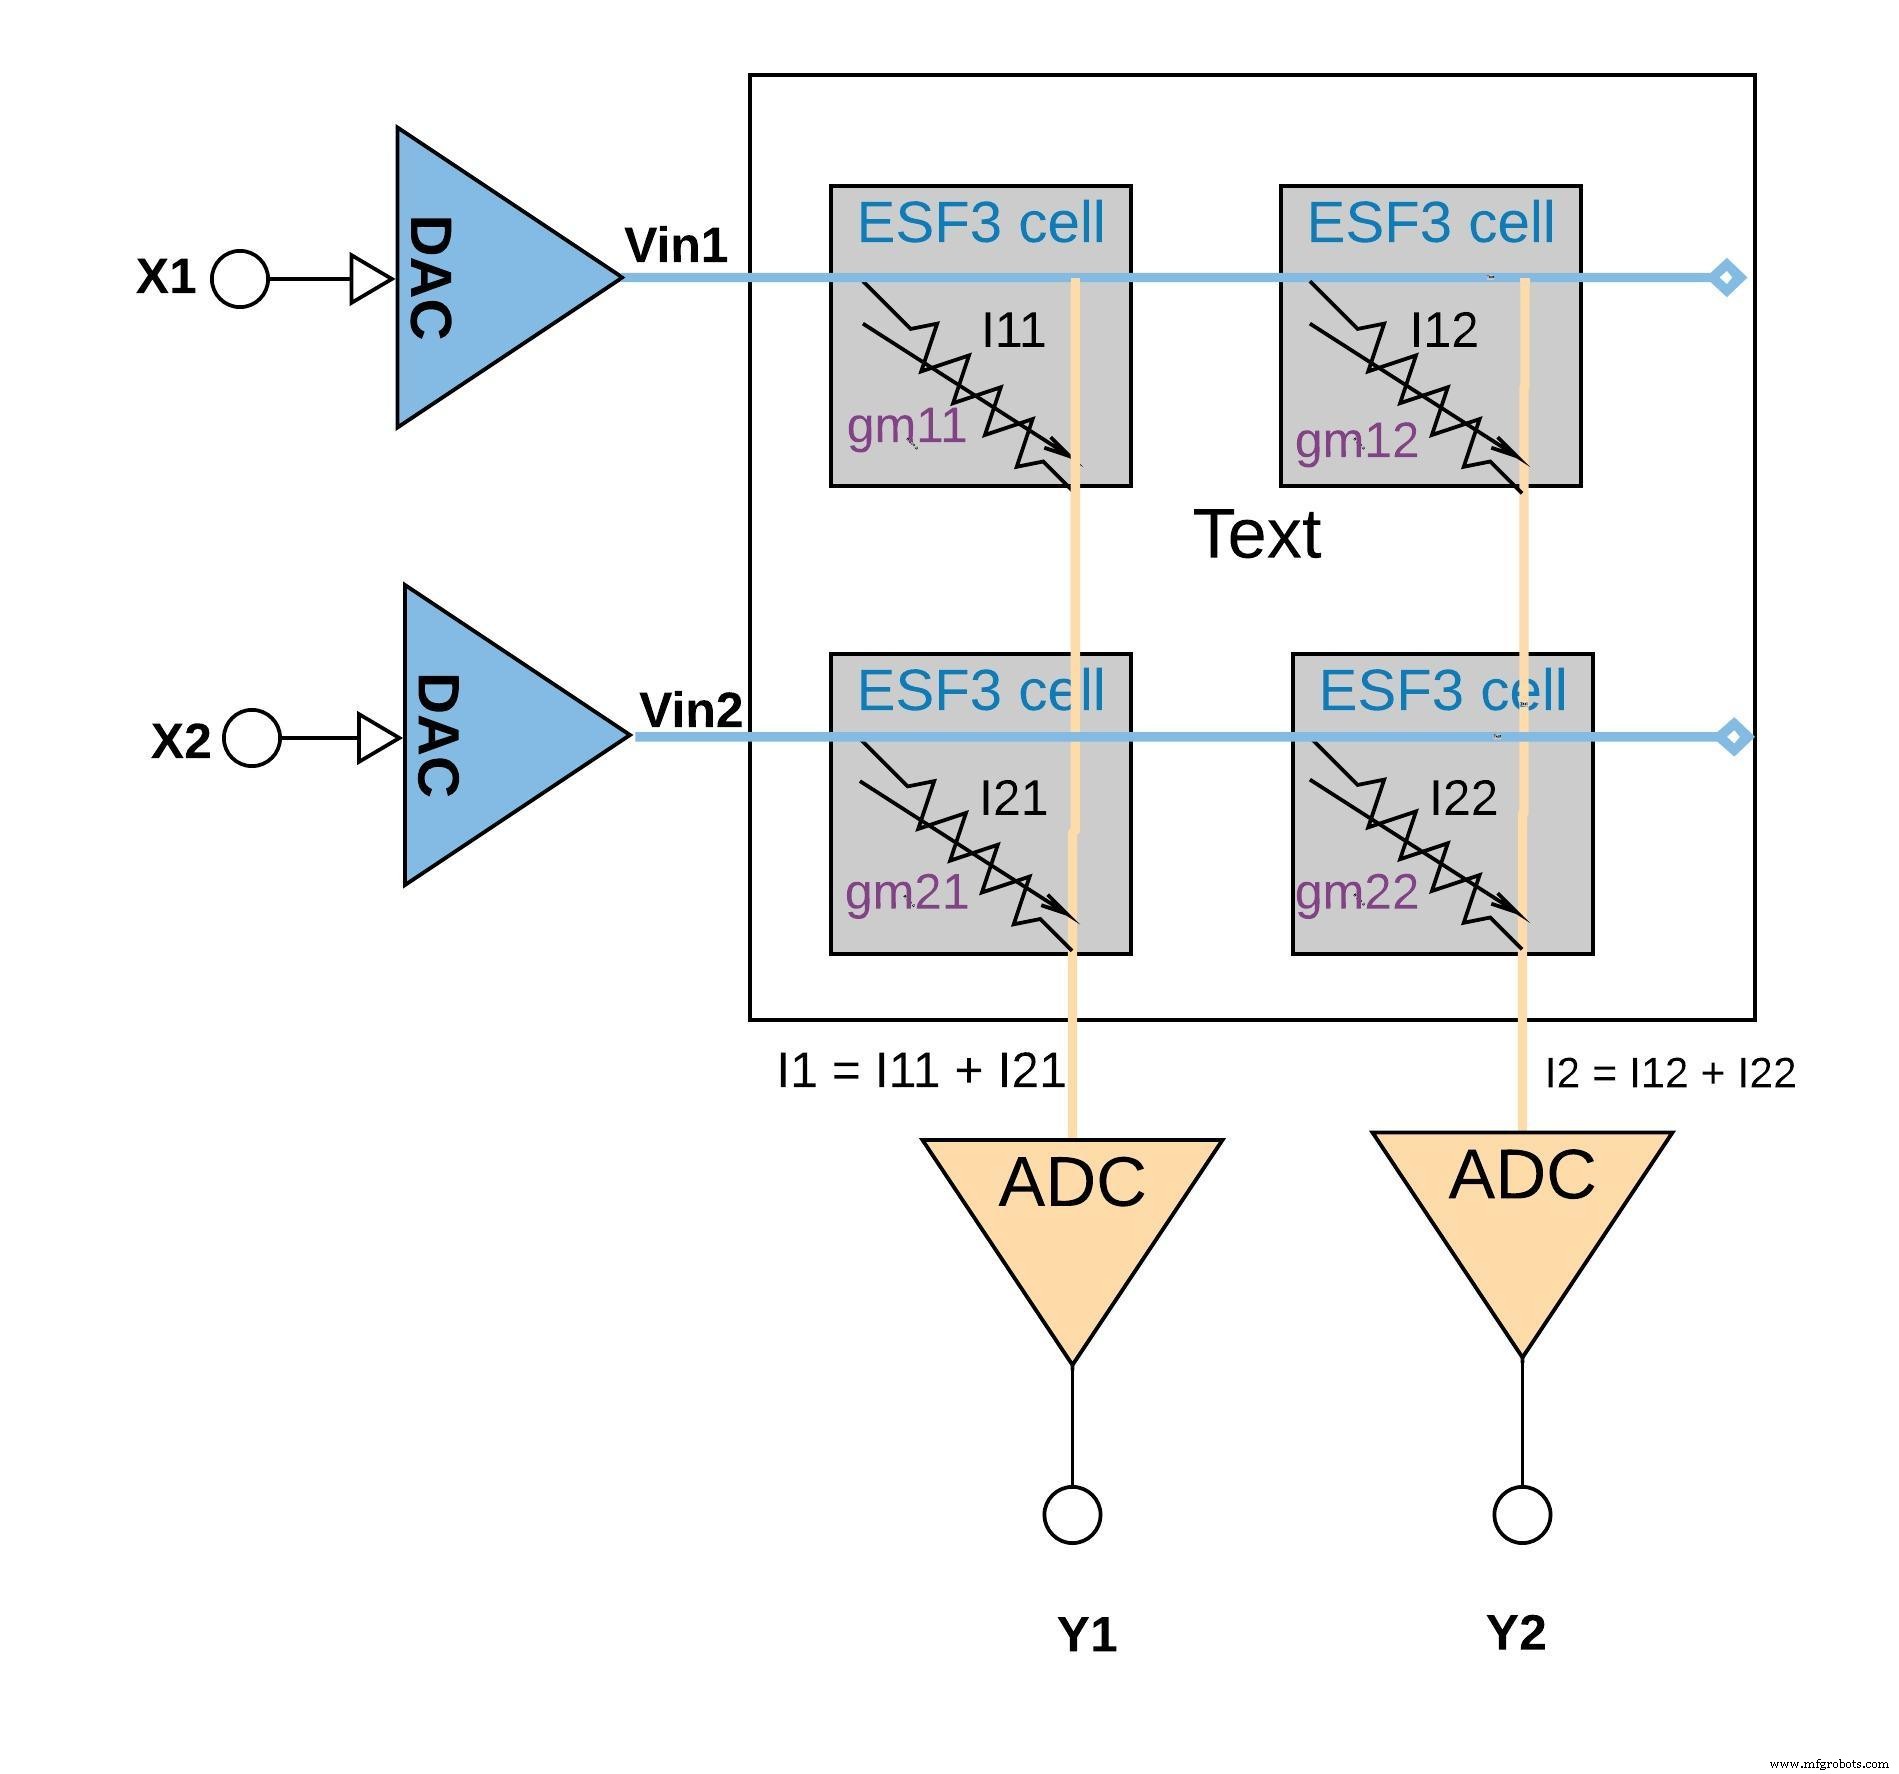 Figuur 6: Multiply-Accumulate-operatie met ESF3-array (2×2). (Bron: Microchip Technology)
Op grotere schaal kan een gewichtsmatrix op een enkele geheugenarray gemapt worden. Figuur 7 toont de matrix-layout voor een fully-connected-laag.
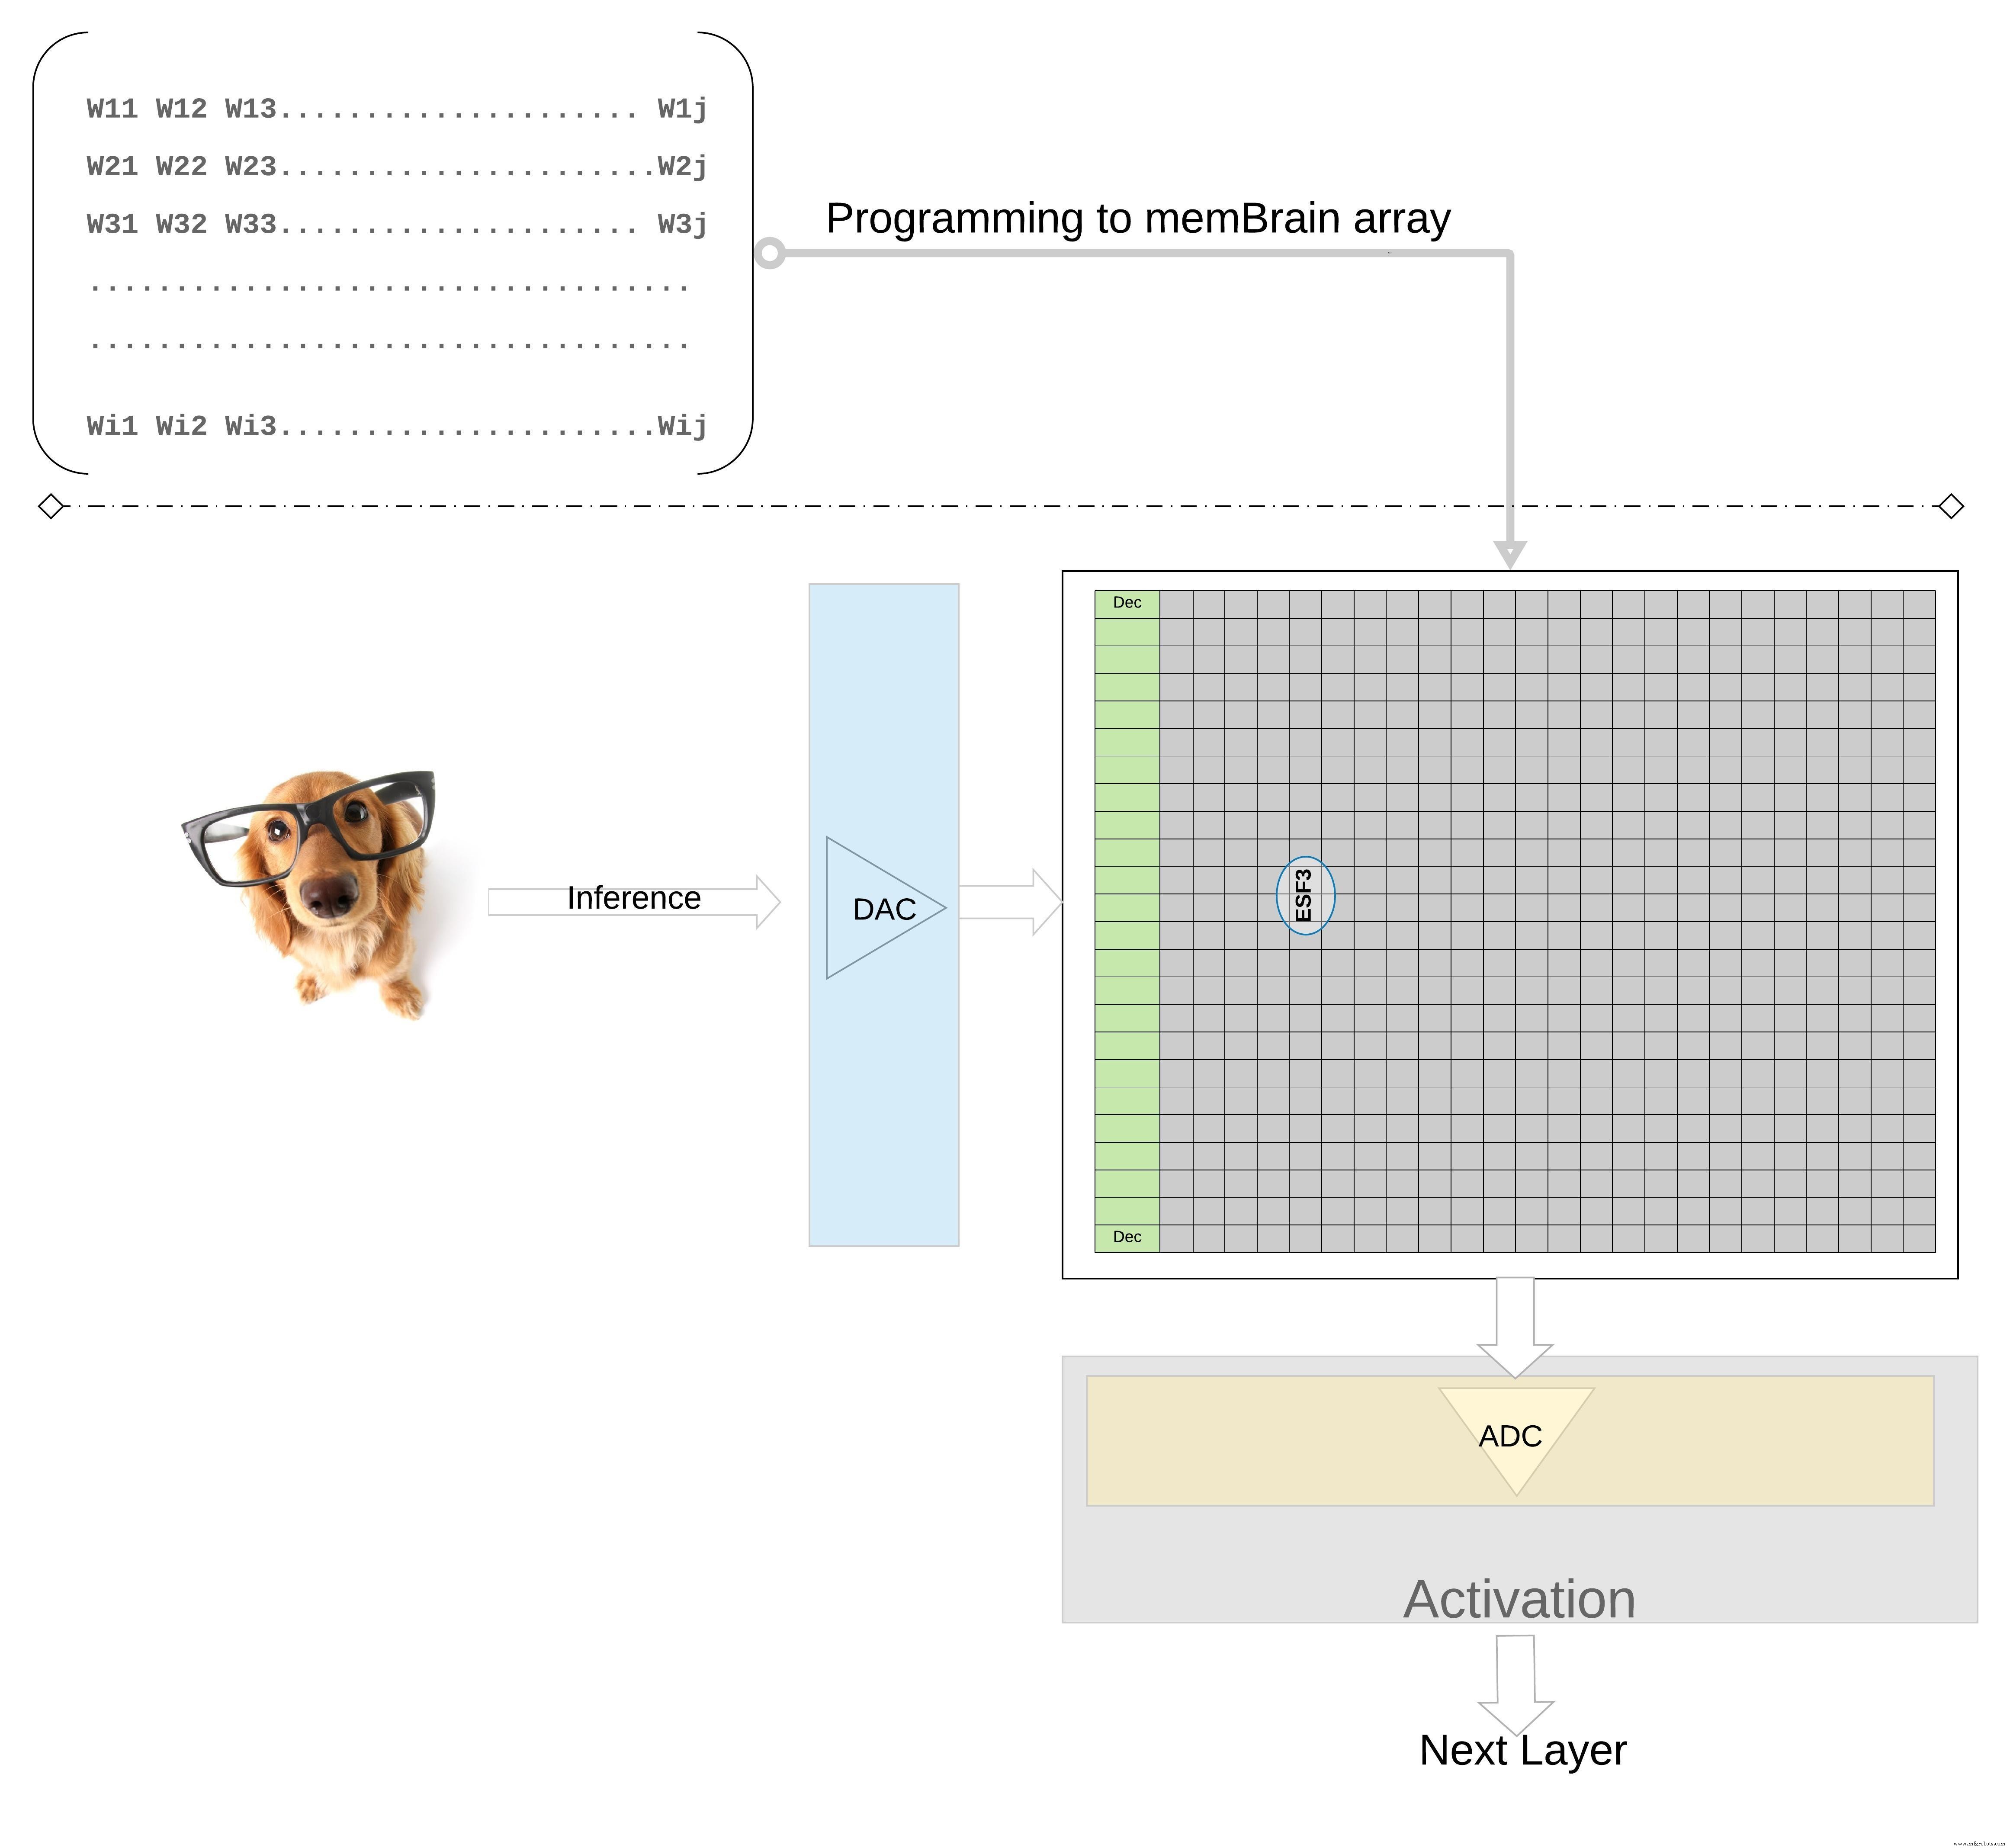 Figuur 7: Gewichtsmatrix geheugenarray voor inferentie. (Bron: Microchip Technology)
De inferentie-stroom is straightforward: sensordata wordt gedigitaliseerd, omgezet in een analoge spanning door een DAC, in de array eingespeist, en de resulterende kolomstromen worden gedigitaliseerd door een ADC voor opvolgende activatie- en pooling-stages.
Modulariteit en schaalbaarheid
memBrain-tegels zijn ontworpen om gestapeld te worden. Figuur 8 toont een 3×4-configuratie waar meerdere tegels een gemeenschappelijke analoge-digitale interconnect delen. Data beweegt over tegels via een gedeelde bus, wat de constructie van diepe netwerken zonder een enkele monolithische die mogelijk maakt.
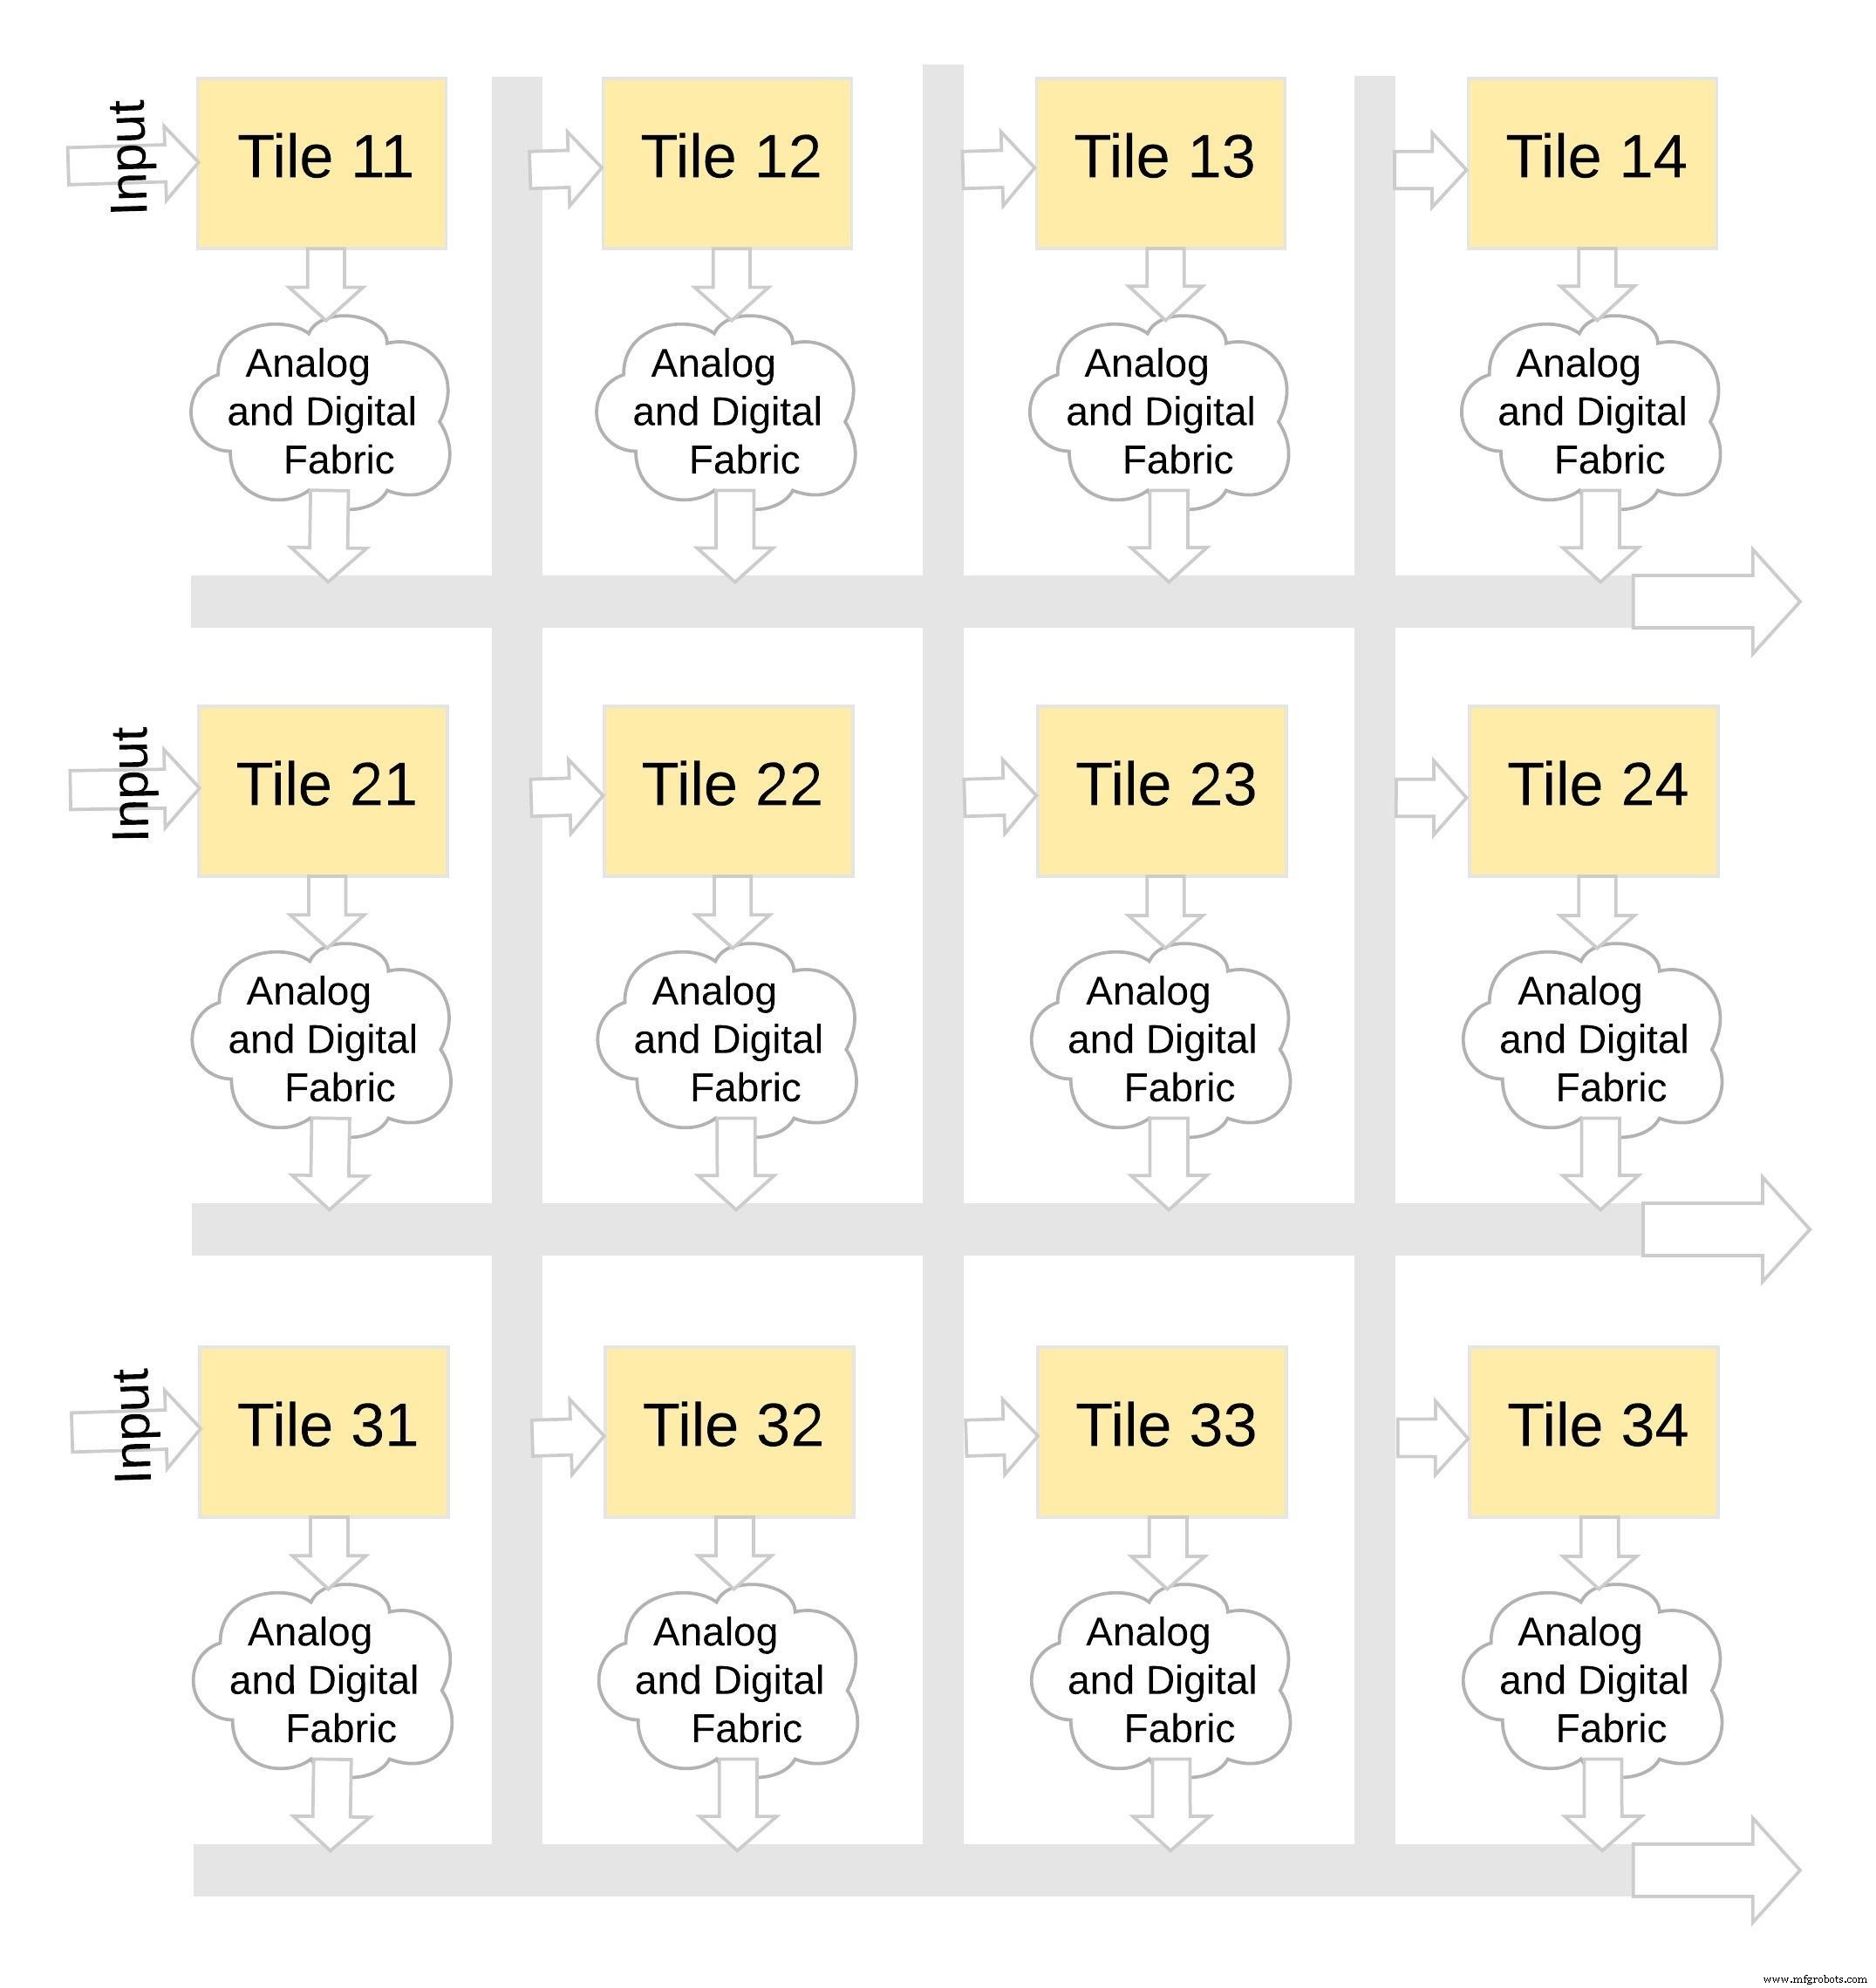 Figuur 8: memBrain™ is modulair. (Bron: Microchip Technology)
Software Development Kit (SDK)
De bijbehorende SDK is framework-agnostisch. Of je nu traint in TensorFlow, PyTorch of een andere bibliotheek, de SDK hanteert model-quantisatie, mapping en deployment naar de memBrain-hardware. Figuur 9 schetst de workflow van training naar inferentie.
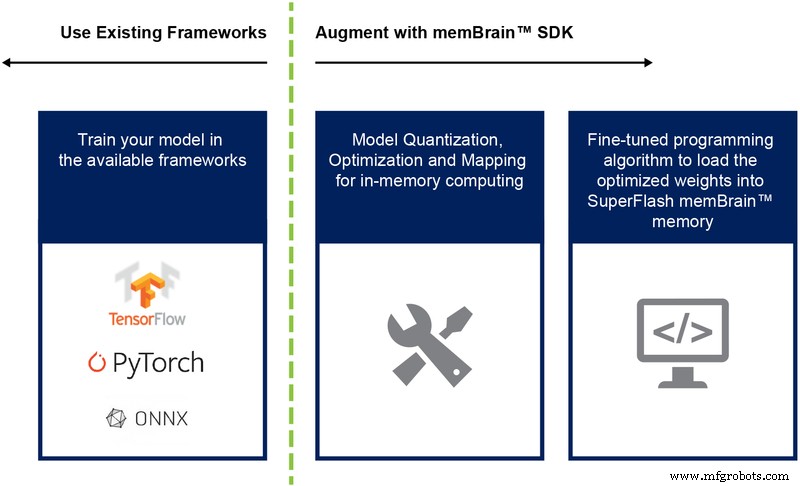 Figuur 9: memBrain™ SDK-flow. (Bron: Microchip Technology)
Kernvoordelen
- Ultra-laag vermogen – In-memory compute elimineert data-verplaatsing, flash-cellen werken sub-threshold, en geen standby-power is nodig. De architectuur exploiteert ook sparsiteit, aangezien nul-gewichten of -inputs cellen idle laten.
- Compacte footprint – De 1,5-transistor split-gate-cel slaat een 4-bit-waarde op, terwijl een 6-transistor SRAM 24 transistoren voor dezelfde data zou vereisen. Het resultaat is een dramatisch kleiner die-area.
- Gereduceerde ontwikkelkosten – Door gebruik te maken van volwassen flash-processen en de noodzaak voor ultra-dichte geometrieën te vermijden, worden mask-set-kosten en lead-times significant verlaagd ten opzichte van ASIC's ontworpen voor edge AI.
Edge AI belooft transformatieve toepassingen, maar vermogen en kosten blijven limiterende factoren. Analoge in-memory computing, ondersteund door bewezen multi-level flash-technologie, biedt een praktisch, laag-kosten pad om intelligente inferentie direct naar de sensor te brengen.
Ingebed
- Hoe Stroomuitvallen Uw Voedingen Bedreigen – En Hoe U Ze Kunt Beschermen
- Hoe Kleine Productiewinkels Kosteneffectief Digitale Oplossingen Kunnen Omarm
- Verbonden Technologie Benutten om Sleutel Supply Chain Uitdagingen Op te Lossen
- Hoe Edge Computing Enterprise IT Kan Transformeren: Een Gebalanceerd Perspectief
- Waarom Cloud Computing IT-Teams Maakt
- Edge Computing Ontmaskerd: Praktische Use Cases in Transport, Utilities en Productie
- Edge Computing: 5 Potentiële Valkuilen – en Hoe Ze Te Overwinnen
- IIoT-data benutten om winstgevendheid in lean manufacturing te drijven
- Edge Computing: De katalysator die Industrie 4.0 vooruit drijft
- 6 Overtuigende Redenen om Edge Computing te Omhelzen
- Edge Computing & 5G: De drijfveer achter bedrijfstransformatie