



Uw Multilayer Perceptron trainen: Bewijste strategieën voor optimale prestaties
We kunnen de prestaties van een Perceptron aanzienlijk verbeteren door een laag verborgen knooppunten toe te voegen, maar die verborgen knooppunten maken training ook wat ingewikkelder.
Tot nu toe in de AAC reeks over neurale netwerken, hebt u geleerd over data classificatie met neurale netwerken, met name van de Perceptron-variëteit.
Haak de reeks hieronder aan of duik in deze nieuwe entry die de basis van het multilayer Perceptron (MLP) neuraal netwerk uitlegt.
- Hoe classificatie uit te voeren met een neuraal netwerk: Wat is de Perceptron?
- Hoe een simpele Perceptron-neuraal netwerk voorbeeld te gebruiken om data te classificeren
- Hoe een basale Perceptron-neuraal netwerk te trainen
- Eenvoudige neuraal netwerk training begrijpen
- Inleiding tot trainings theorie voor neurale netwerken
- Leer snelheid in neurale netwerken begrijpen
- Geavanceerde machine learning met de Multilayer Perceptron
- De Sigmoid-activeringsfunctie: Activering in Multilayer Perceptron neurale netwerken
- Hoe een Multilayer Perceptron neuraal netwerk te trainen
- Trainingsformules en Backpropagation voor Multilayer Perceptrons begrijpen
- Neuraal netwerk architectuur voor een Python-implementatie
- Hoe een Multilayer Perceptron neuraal netwerk in Python te maken
- Signaalverwerking met neurale netwerken: Validatie in neuraal netwerk ontwerp
- Trainingsdatasets voor neurale netwerken: Hoe een Python neuraal netwerk te trainen en valideren
Wat is een Multilayer Perceptron Neuraal Netwerk?
Het vorige artikel demonstreerde dat een eenlaags Perceptron simpelweg niet de prestaties kan leveren die we verwachten van een moderne neuraal-netwerk architectuur. Een systeem dat beperkt is tot lineair scheidbare functies kan de complexe input-output relaties die in real-life signaalverwerkingsscenario's voorkomen niet benaderen. De oplossing is een multilayer Perceptron (MLP), zoals deze:
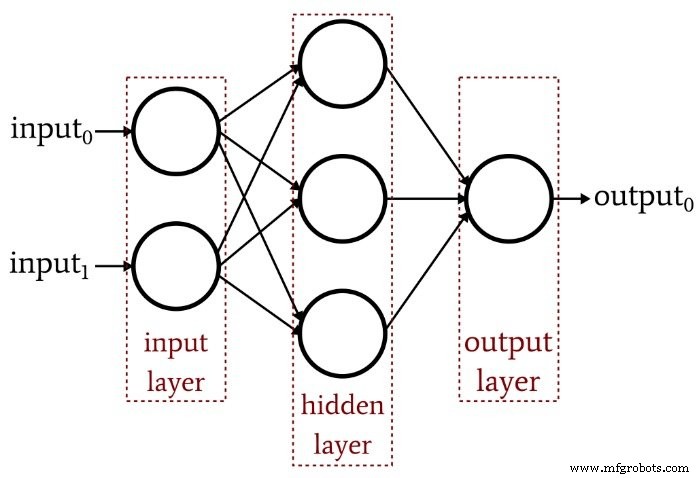
Door die verborgen laag toe te voegen, veranderen we het netwerk in een "universele benaderder" dat extreem gesofisticeerde classificatie kan bereiken. Maar we moeten altijd onthouden dat de waarde van een neuraal netwerk volledig afhankelijk is van de kwaliteit van de training. Zonder overvloedige, diverse trainingsdata en een effectieve trainingsprocedure, zal het netwerk nooit "leren" hoe invoermonsters te classificeren.
Waarom de verborgen laag training compliceert
Laten we kijken naar de leerregel die we gebruikten om een eenlaags Perceptron te trainen in een vorig artikel:
\[w_{new} = w+(\alpha\times(output_{expected}-output_{calculated})\times input)\]
Let op de impliciete assumptie in deze vergelijking: We updaten de gewichten gebaseerd op de waargenomen uitvoer, dus voor dit te laten werken, moeten de gewichten in de eenlaags Perceptron de uitvoerwaarde direct beïnvloeden. Het is als de temperatuur van kraanwater kiezen door de twee knopen voor warm en koud te draaien. De relatie tussen de algehele temperatuur en de knopactie is redelijk straightforward, en zelfs mensen die niet van hou van wiskunde kunnen de gewenste watertemperatuur vinden door even met de knopen te knoeien.
Maar nu voorstellen dat de waterstroom door de warme en koude pijpen gerelateerd is aan de knoppositie op een complexe, hoogst niet-lineaire manier. Je draait de knop voor warm water langzaam en stapsgewijs, maar de resulterende stroomsnelheid varieert erratisch. Je probeert de knop voor koud water en het doet hetzelfde. De ideale watertemperatuur vinden onder deze voorwaarden – met name aangezien de "uitvoer" bereikt moet worden door een combinatie van twee verwarrende controle-relaties – zou veel moeilijker zijn.
Dit is hoe ik het dilemma van de verborgen laag begrijp. De gewichten die de invoerknooppunten verbinden met de verborgen knooppunten zijn conceptueel analogon aan die mechanisch erratische knopen – omdat invoer-naar-verborgen gewichten geen direct pad naar de uitvoerlaag hebben, is de relatie tussen deze gewichten en de netwerkuitvoer zo complex dat de eenvoudige leerregel hierboven niet effectief zal zijn.
Een nieuw trainingsparadigma
Omdat de oorspronkelijke Perceptron-leerregel niet kan worden toegepast op multicouche netwerken, moeten we onze trainingsstrategie heroverwegen. Wat we gaan doen is gradiëntdal en minimalisatie van een foutfunctie incorporeren.
Eén ding om in gedachten te houden is dat deze trainingsprocedure niet specifiek is voor multicouche neurale netwerken. Gradiëntdal komt uit de algemene optimalisatietheorie, en de trainingsprocedure die we voor MLP's gebruiken is ook toepasbaar op eenlaags netwerken. Echter, zoals ik het begrijp, is MLP-stijl gradiëntdal (tenminste theoretisch) onnodig voor een eenlaags Perceptron, omdat de eenvoudigere regel hierboven uiteindelijk het werk zal doen.
Het afleiden van de daadwerkelijke gewichts-update vergelijkingen voor een MLP omvat enige intimidante wiskunde die ik op dit moment niet zal proberen intelligibel uit te leggen. Mijn doel voor de rest van dit artikel is een conceptuele introductie te bieden tot twee kernaspecten van MLP-training – gradiëntdal en de foutfunctie – en dan zullen we deze discussie in het volgende artikel voortzetten door een nieuwe activeringsfunctie te incorporeren.
Gradiëntdal
Zoals de naam impliceert, is gradiëntdal een middel om af te dalen naar het minimum van een foutfunctie gebaseerd op helling. Het onderstaande diagram vermittelt de manier waarop een gradiënt ons informatie geeft over hoe gewichten te wijzigen – de helling van een punt op de foutfunctie vertelt ons welke richting we op moeten gaan en hoe ver we van het minimum af zijn.
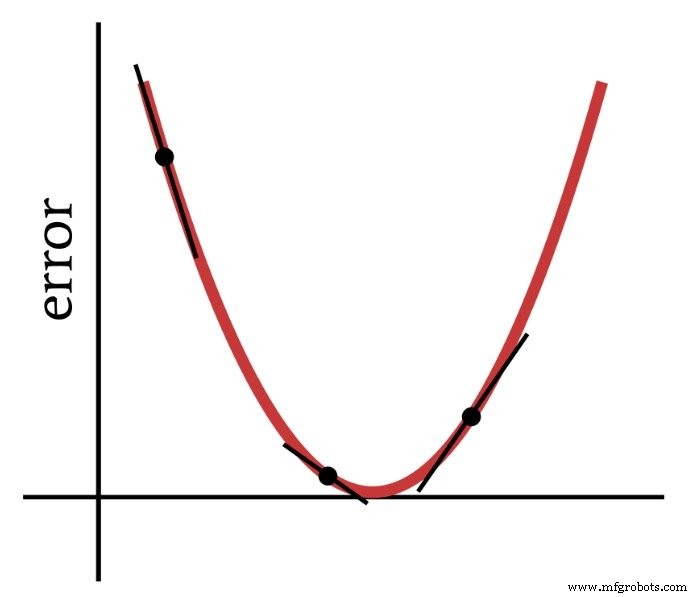
Dus, de afgeleide van de foutfunctie is een belangrijk element van de berekeningen die we gebruiken om een multilayer Perceptron te trainen. Eigenlijk zullen we partiële afgeleiden hier nodig hebben. Wanneer we gradiëntdal implementeren, maken we elke gewichtsmodificatie proportioneel aan de helling van de foutfunctie ten opzichte van het gewicht dat gewijzigd wordt.
De Foutfunctie (AKA Verliesfunctie)
Een veelvoorkomende methode om een neuraal netwerks fout te kwantificeren is het kwadrateren van het verschil tussen de verwachte (of "doel") waarde en de berekende waarde voor elk uitvoerknooppunt, en dan al deze gekwadrateerde verschillen op te tellen. U kunt dit "som van gekwadrateerde verschillen" of "opgetelde gekwadrateerde fout" noemen of misschien verschillende andere dingen, en u zult ook de afkorting LMS zien, wat staat voor least-mean-square, omdat het doel van training is om de gemiddelde gekwadrateerde fout te minimaliseren. Deze foutfunctie (aangeduid met E) kan wiskundig als volgt worden uitgedrukt:
\[E=\frac{1}{2}\sum_k(t_k-o_k)^2\]
waar k het bereik van uitvoerknooppunten aangeeft, t de doeluitvoerwaarde is, en o de berekende uitvoerwaarde.
Conclusie
We hebben de basis gelegd voor het succesvol trainen van een multilayer Perceptron, en we zullen dit interessante onderwerp in het volgende artikel verder verkennen.
Industriële robot
- Netwerktopologieën begrijpen: van point-to-point tot ring en ster
- Ontdek Uw Netwerkbeveiligingssleutel: Eenvoudige Stappen om uw Wi‑Fi te Vinden en Beveiligen
- Kunstmatige Neurale Netwerken Verbeteren Draadloze Communicatieprestaties
- De Beveiliging van Uw Shopfloor-Netwerk Beoordelen: Bent U Klaar?
- Morgen's Werkvoorbereiden voor Industrie 4.0: Trainingsstrategieën voor de Digitale Fabriek
- Lokale Minima in Neuraal Netwerk Training: Myth of Realiteit?
- Hoe word je auto-electrician: opleiding, taken en carrièreperspectieven
- CEVA onthult NeuPro-S: next-gen AI-processor voor edge deep neural network inferentie
- Industriële IoT-apparaten Hardenen om Cyberaanvallen te Voorkomen
- Hoe verbonden netwerken de moderne landbouw revolutioneren
- Hoe intelligente netwerken zakelijke efficiëntie en groei drijven