



Gewichtsupdates en Backpropagation in Multilayer Perceptrons onder de knie krijgen
In dit artikel presenteren we de precieze vergelijkingen voor gewichts-update berekeningen en leggen uit hoe backpropagation een multilayer perceptron (MLP) in staat stelt om van data te leren.
Welkom bij AAC's uitgebreide machine-learning reeks.
Haak de reeks tot nu toe hier aan:
- Hoe classificatie uit te voeren met een neuraal netwerk: Wat is de Perceptron?
- Hoe een simpele Perceptron-neuraal netwerk voorbeeld te gebruiken om data te classificeren
- Hoe een basale Perceptron-neuraal netwerk te trainen
- Eenvoudige neuraal netwerk training begrijpen
- Inleiding tot trainings theorie voor neurale netwerken
- Leer snelheid in neurale netwerken begrijpen
- Geavanceerde machine learning met de Multilayer Perceptron
- De Sigmoid-activeringsfunctie: Activering in Multilayer Perceptron neurale netwerken
- Hoe een Multilayer Perceptron neuraal netwerk te trainen
- Trainingsformules en Backpropagation voor Multilayer Perceptrons begrijpen
- Neuraal netwerk architectuur voor een Python-implementatie
- Hoe een Multilayer Perceptron neuraal netwerk in Python te maken
- Signaalverwerking met neurale netwerken: Validatie in neuraal netwerk ontwerp
- Trainingsdatasets voor neurale netwerken: Hoe een Python neuraal netwerk te trainen en valideren
We hebben de kern van neuraal-netwerk theorie bereikt: de computationele stappen die een MLP's gewichten fijnstellen zodat het invoermonsters accuraat kan classificeren. Dit proces is de fundament van het backpropagation-algoritme, een hoeksteen van moderne deep learning.
Gewichten bijwerken
Het trainen van een MLP is wiskundig dicht, en terminologie varieert over bronnen. De onderstaande vergelijkingen zijn afgeleid van Dr. Dustin Stansbury's heldere derivaties, wat ze een uitstekende referentie maakt voor zowel beginners als praktijkers.
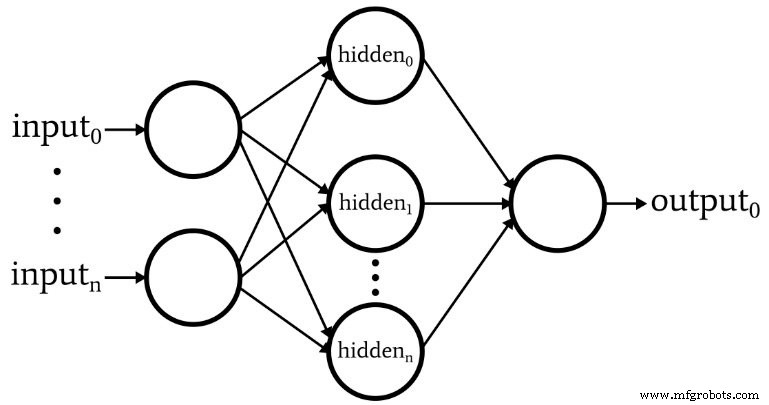
Het diagram toont de architectuur die we in code zullen implementeren, en de vergelijkingen die volgen mappen direct op deze structuur.
Terminologie
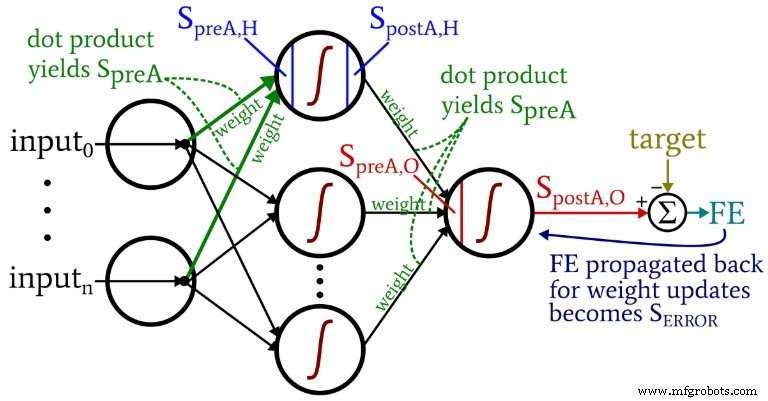
- Pre-activering (SpreA): De gewogen som invoer aan een neurones activeringsfunctie, berekend als een dot-product van binnenkomende gewichten en activeringen.
- Post-activering (SpostA): De neurones uitvoer na toepassing van de activeringsfunctie fA(·). We gebruiken de logistische (sigmoid) functie in onze voorbeelden.
- Gewichtsmatrices: In code labelen we ze ItoH (invoer-naar-verborgen) en HtoO (verborgen-naar-uitvoer) om ambiguïteit te vermijden.
- Doel (T): De correcte uitvoer voor een trainingsmonster.
- Leersnelheid (LR): De stapgrootte voor gewichtsupdates.
- Eindfout (FE): SpostA,O – T.
- Foutsignaal (SERROR): FE vermenigvuldigd met de afgeleide van de uitvoerneurones activeringsfunctie.
- Gradiënt: De bijdrage van een specifiek gewicht aan het foutsignaal; we trekken LR × gradiënt af van het huidige gewicht.
Het bijbehorende diagram illustreert deze concepten in context.
Gewichts-update vergelijkingen voortkomen uit het nemen van de partiële afgeleide van de som-gekwadrateerde fout ten opzichte van elk gewicht. Voor verborgen-naar-uitvoer gewichten:
SERROR = FE × fA'(SpreA,O)
gradiëntHtoO = SERROR × SpostA,H
gewichtHtoO ← gewichtHtoO – (LR × gradiëntHtoO)
Voor invoer-naar-verborgen gewichten moet de fout een extra laag doorkruisen:
gradiëntItoH = SERROR × gewichtHtoO × fA'(SpreA,H) × invoer
gewichtItoH ← gewichtItoH – (LR × gradiëntItoH)
Backpropagation
Backpropagation lost het verborgen-knooppunt dilemma op: hoewel invoer-naar-verborgen gewichten de uiteindelijke uitvoer indirect beïnvloeden, kunnen we hun effect berekenen door het foutsignaal achterwaarts door het netwerk te propageren en te schalen met de uitgaande gewichten en activeringsafgeleiden. Deze techniek is fundamenteel voor het trainen van diepe modellen.
Conclusie
We hebben de sleutelvergelijkingen die gewichtsupdates drijven en de mechanica van backpropagation in MLP's uitgepakt. Deze concepten liggen ten grondslag aan elke moderne neuraal-netwerk toepassing, en het meesteren ervan opent de deur naar geavanceerde modellering. Blijf op de hoogte voor de volgende afleveringen in onze reeks, waar we dieper ingaan op architectuurontwerp, Python-implementatie, en validatietechnieken.
Industriële robot
- Schokbestendige toolstalen: poincon- en matrijsprestaties meesteren
- Hybride productie: belangrijke voordelen, uitdagingen en industriële impact
- Verhoog uw expertise met BECKER's expert vacuümpomp training
- Versnel Robotlas Training: Tijd Winst, Efficiëntie Boost
- CEVA onthult NeuPro-S: next-gen AI-processor voor edge deep neural network inferentie
- Cisco 1G Bidirectionele Transceivers: Service Provider en IoT Netwerkefficiëntie Boosten
- Slimme Core Network Slicing voor IoT en MVNO's: 5G-potentieel Ontgrendelen in 3G/4G Netwerken
- 5G's Top Vijf Uitdagingen: Spectrum, Kosten, Dekking, Apparaten en Beveiliging Navigeren
- Implementeren En Beheren Van Draadloze Sensornetwerken In Het Bedrijf
- Lean & Six Sigma: Een praktische gids voor productie-excellentie
- Senet & SimplyCity breiden LoRaWAN IoT uit voor slimme boerderijen, industrie en stedelijke duurzaamheid