



Verborgen laag grootte optimaliseren voor betere neuraal netwerk nauwkeurigheid
In dit artikel voeren we classificatie-experimenten uit en analyseren hoe de dimensionaliteit van de verborgen laag de prestaties van een neuraal netwerk beïnvloedt.
Leer hoe het aanpassen van de verborgen laag in een Perceptron de nauwkeurigheid kan verbeteren, de trainingsduur kan verminderen en acceptabele latentie kan behouden – allemaal gedemonstreerd met een Python-implementatie en echte datasets.
Voordat we ingaan, bekijk eerdere artikelen in onze neurale netwerk reeks om een stevige basis op te bouwen:
- Hoe classificatie uit te voeren met een neuraal netwerk: Wat is de Perceptron?
- Hoe een simpele Perceptron-neuraal netwerk voorbeeld te gebruiken om data te classificeren
- Hoe een basale Perceptron-neuraal netwerk te trainen
- Eenvoudige neuraal netwerk training begrijpen
- Inleiding tot trainings theorie voor neurale netwerken
- Leer snelheid in neurale netwerken begrijpen
- Geavanceerde machine learning met de Multilayer Perceptron
- De Sigmoid-activeringsfunctie: Activering in Multilayer Perceptron neurale netwerken
- Hoe een Multilayer Perceptron neuraal netwerk te trainen
- Trainingsformules en Backpropagation voor Multilayer Perceptrons begrijpen
- Neuraal netwerk architectuur voor een Python-implementatie
- Hoe een Multilayer Perceptron neuraal netwerk in Python te maken
- Signaalverwerking met neurale netwerken: Validatie in neuraal netwerk ontwerp
- Trainingsdatasets voor neurale netwerken: Hoe een Python neuraal netwerk te trainen en valideren
- Hoeveel verborgen lagen en verborgen knooppunten heeft een neuraal netwerk nodig?
- Hoe de nauwkeurigheid van een verborgen laag neuraal netwerk te verhogen
Het aantal knooppunten in een verborgen laag beïnvloedt direct de classificatienauwkeurigheid en trainingsnelheid. Onze experimenten bieden data-gedreven inzichten voor het selecteren van een verborgen-laag grootte die snelheid, latentie en nauwkeurigheid in balans brengt.
Benchmarken in Python
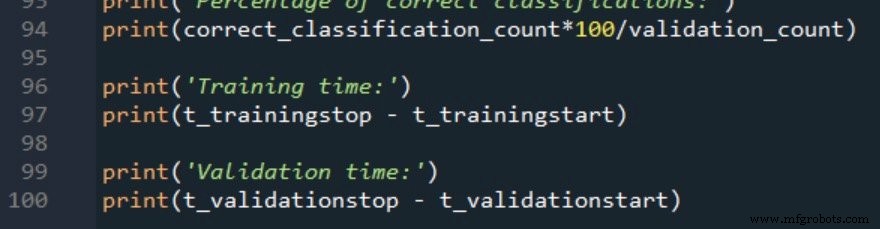
We breiden de bestaande Python-code uit deel 12 uit om trainings- en validatieduur te registreren met time.perf_counter(). Hieronder de timing-instrumentatie:
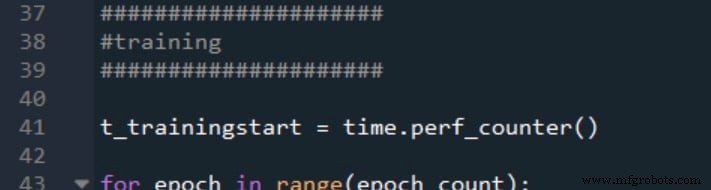
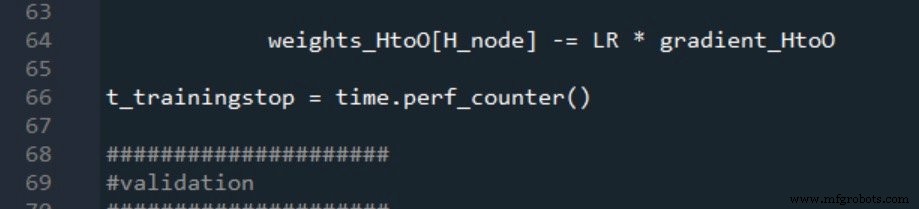
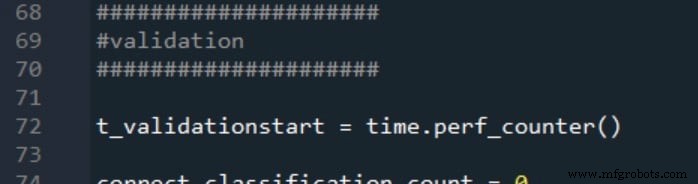
Validatietiming volgt hetzelfde patroon:
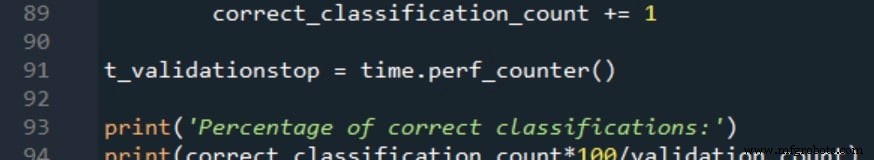
De resultaten worden gerapporteerd als:
Trainingsdata en meetprocedure
We testen een binaire classificatietaak met vier numerieke invoeren variërend van –20 tot +20. De netwerkarchitectuur is 4 invoerknooppunten, een enkele verborgen laag en één uitvoerknooppunt. Invoewaarden worden gegenereerd met de Excel-formule hieronder:
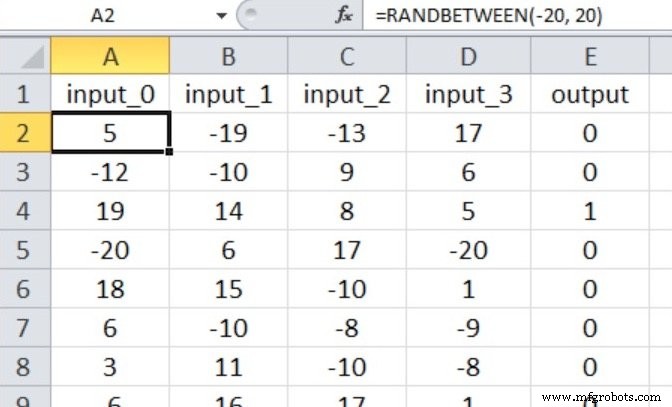
Datasetgrootte: 40.000 trainingsmonsters en 5.000 validatiemonsters. We gebruiken een leersnelheid van 0.1 en voeren één volledige epoch per run uit. Elke verborgen-laag dimensie wordt vijf keer getest; de gerapporteerde nauwkeurigheid en timing zijn rekenkundige gemiddeldes.
Experiment 1: Laag-complexiteitsprobleem
Het doel is alleen waar wanneer de eerste drie invoeren nul overschrijden; de vierde invoer is irrelevant:
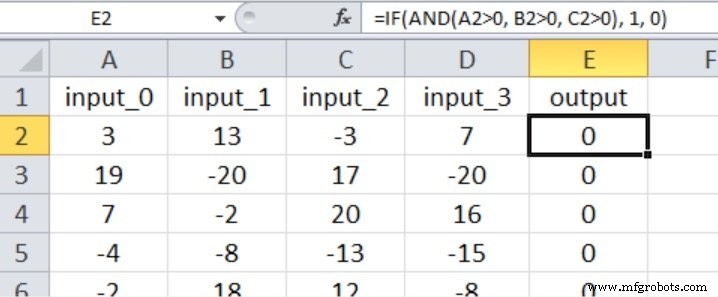
Volgens de richtlijn van twee-derde van de invoergrootte beginnen we met H_dim = 2. Resultaten worden hieronder samengevat:
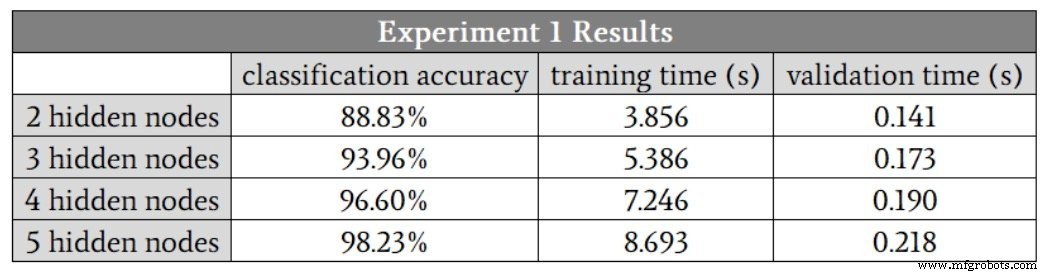
Nauwkeurigheid verbetert tot vijf verborgen knooppunten, maar de marginale winst van vier naar vijf knooppunten is bescheiden omdat één run met vier knooppunten een uitloper was (88,6%). Zonder die uitloper presteren vier knooppunten licht beter dan vijf. Trainingsduur stijgt 1,9× van twee naar vier knooppunten, terwijl validatietijd slechts 1,3× toeneemt, wat benadrukt dat training de rekenintensieve fase is.
Experiment 2: Matig-complexiteitsprobleem
Alle vier invoeren beïnvloeden de uitvoer, met genuanceerdere vergelijkingen:
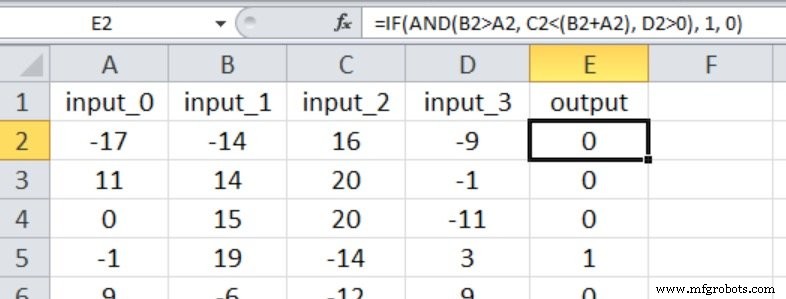
Startend met drie verborgen knooppunten, zijn de resultaten:
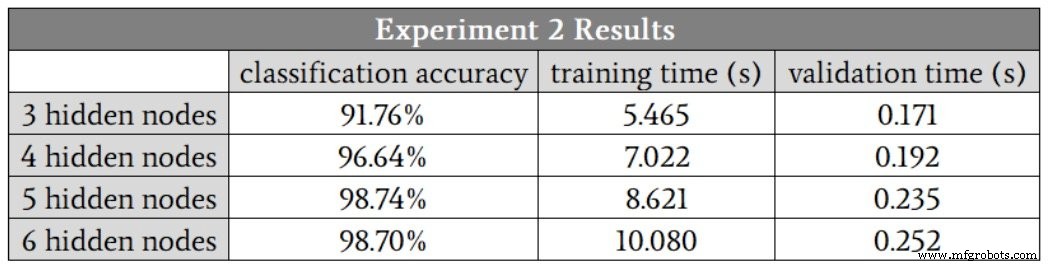
Hier lijken vijf verborgen knooppunten optimaal, balancerend nauwkeurigheid en snelheid. In tegenstelling tot experiment 1 tonen de runs met vijf en zes knooppunten geen lage-nauwkeurigheid uitlopers, wat suggereert dat grotere verborgen lagen robuustheid bieden tegen trainingsvariantie.
Experiment 3: Hoog-complexiteitsprobleem
Dit scenario introduceert non-lineariteit: één input is gekwadrateerd, een andere is vierkantswortel:
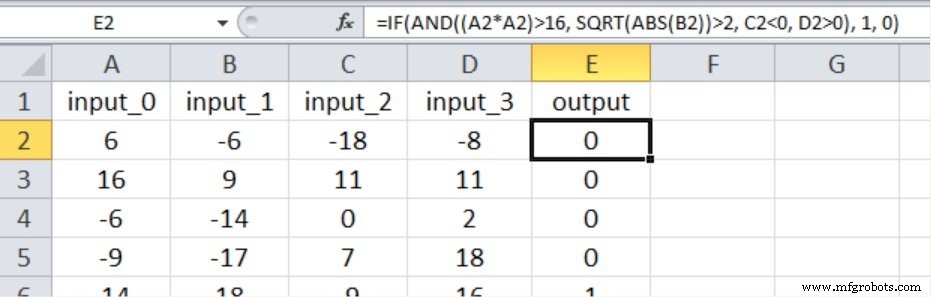
Resultaten als volgt:
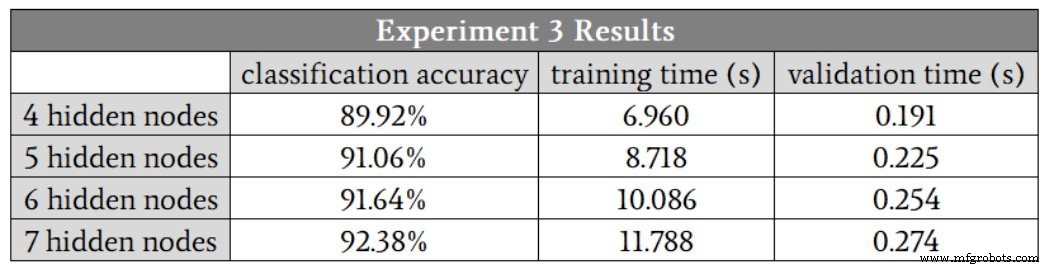
Nauwkeurigheid daalt vergeleken met lagere-complexiteit taken, zelfs met zeven verborgen knooppunten. Verbeteringen zoals een bias-term toevoegen of de leersnelheid annealen kunnen de prestaties verbeteren, maar tot die veranderingen gevalideerd zijn, wordt een zeven-knooppunten verborgen laag aanbevolen.
Conclusie
Deze experimenten illustreren een duidelijke afweging: het vergroten van de verborgen-laag dimensionaliteit verbetert doorgaans nauwkeurigheid en stabiliteit, maar ten koste van langere trainingsduur. Gebruik de data-gedreven inzichten hier om uw ontwerpkeuzes te informeren bij het bouwen van Perceptron-gebaseerde classifiers.
Industriële robot
- Thomas WebTrax vs. Google Analytics & Thomas Netwerk: Welk Tool Drijft Uw Industriële Leads?
- Hoe 0G-netwerksensoren vaccinekoudekettens beschermen
- Het juiste aantal verborgen lagen en knooppunten kiezen in een neuraal netwerk
- Neurale netwerken trainen met Excel: Een Python Multilayer Perceptron bouwen en valideren
- Een Multilayer Perceptron neuraal netwerk bouwen in Python: Een praktische gids
- Een flexibele Perceptron neuraal netwerk ontwerpen in Python
- Uw Multilayer Perceptron trainen: Bewijste strategieën voor optimale prestaties
- De Ideale Lasersnijmachine Kiezen: Productiviteit & Nauwkeurigheid Verhogen
- Een basale Perceptron neuraal netwerk trainen met Python: Stap-voor-stap gids
- Hoe verbonden netwerken de moderne landbouw revolutioneren
- IoT beveiligen van hardware tot applicatie: Een laag-voor-laag blauwdruk