



Machine Learning 101: de vier kern typen begrijpen voor beginners
Geen twijfel: Big Data is een belangrijk deel van toekomstige technologische ontwikkeling. Echter, machine learning (ML) en kunstmatige intelligentie (AI) spelen beiden een belangrijke rol. De relatie: Big Data is voor materialen, machine learning voor methoden, AI voor resultaten.
Wat is Machine Learning?
Machine learning (ML) is een type kunstmatige intelligentie (AI) waarin algoritmes zo geschreven zijn dat het systeem de capaciteit krijgt om automatisch te leren, aan te passen en te verbeteren door ervaring, zonder expliciet geprogrammeerd te worden.
Machine learning-algoritmes bouwen een model op basis van het datatype dat het moet leren; deze data heet "trainingsdata".
Typen machine learning?
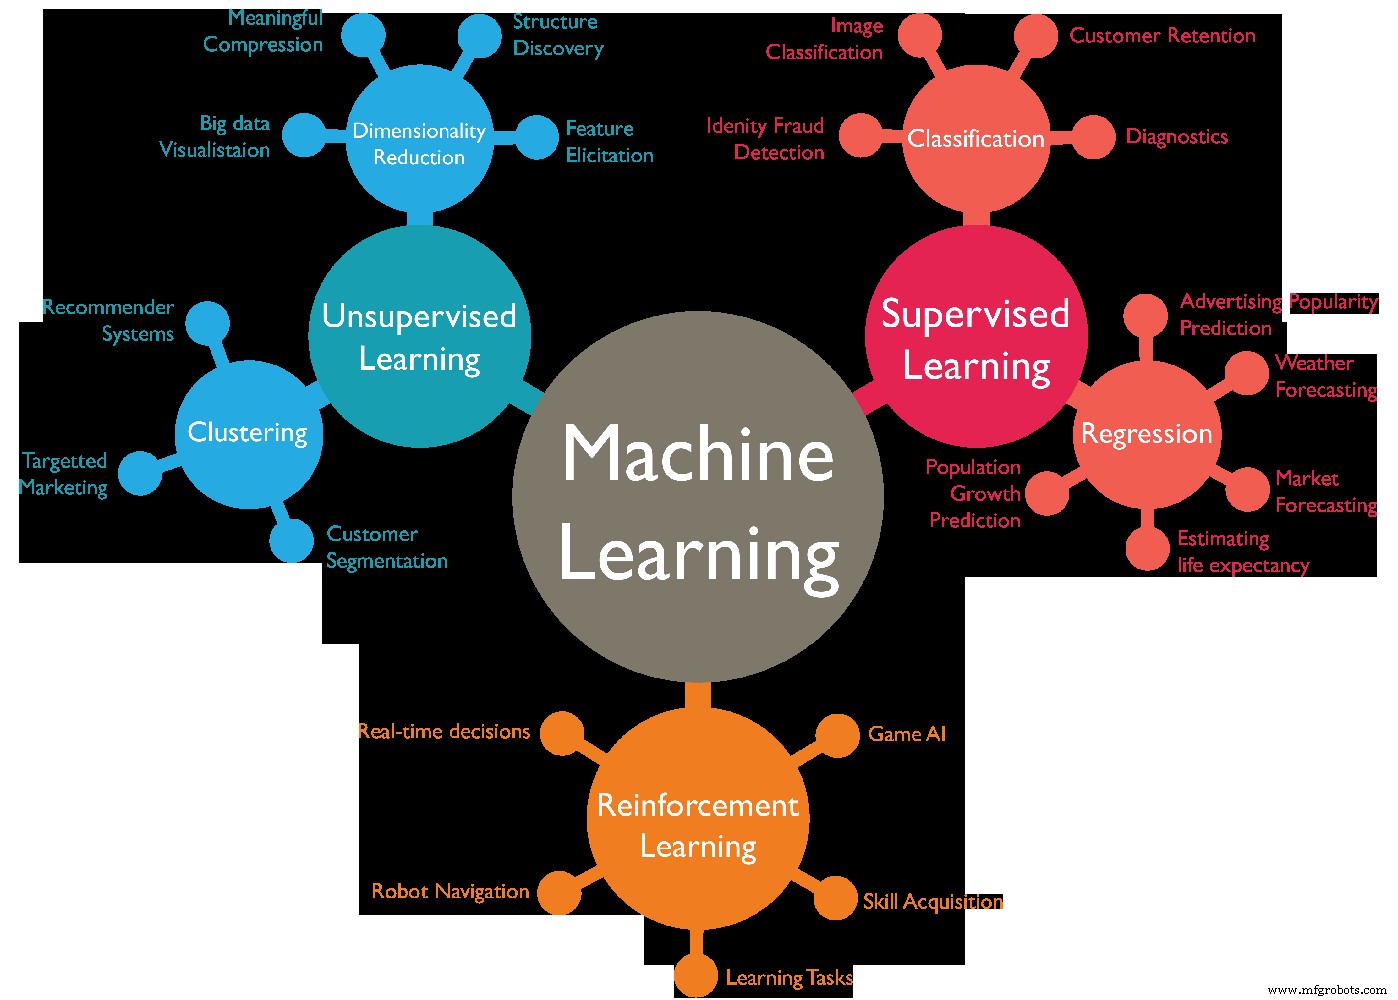
Er zijn diverse typen ML-algoritmes, meestal verdeeld in 4 categorieën:
- Supervised learning.
- Unsupervised learning.
- Semi-supervised learning.
- Reinforcement learning.
Supervised Learning
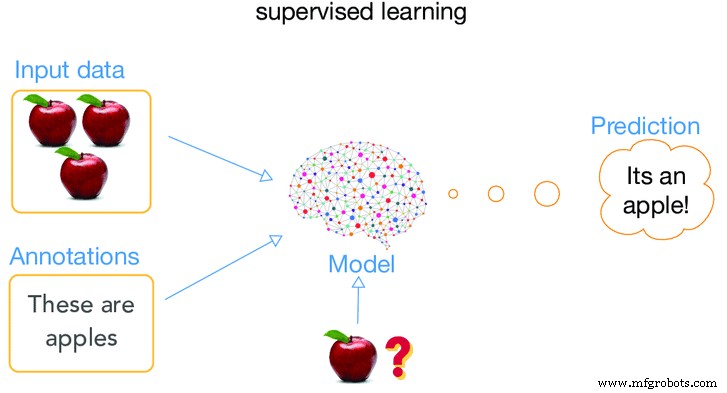
Wanneer de machine begeleid wordt tijdens de "leerfase", heet dit supervised learning. Wat betekent "begeleid" echt? Het betekent algoritmes zo toe te passen dat de machine leert oude data (voorgaand gegeven data) te gebruiken om voorspellingen te maken over toekomstige gebeurtenissen rondom die datatype.
De analyse start en alle materialen in de trainingsdataset zijn gelabeld en gecorreleerd met de machine zodat het de juiste outputwaarden kan voorspellen. We geven de machine veel informatie over een specifiek geval en het levert een uitkomst. De uitkomst heet gelabelde data, de rest is input features. Na voldoende training kan het systeem ook doelen voor nieuwe input geven. Het algoritme vergelijkt output met bedoelde output en vindt verschillen om het model aan te passen.
Afbeelding: artificialintelligence.oodles.io/
Meestal is dit handmatige classificatie, makkelijkst voor computer, moeilijkst voor mensen. Voorbeeld: machine standaardantwoorden leren, bij testen antwoordt machine altijd volgens standaardantwoord – betrouwbaarder.
Unsupervised learning
In tegenstelling tot supervised learning worden unsupervised learning algoritmes gebruikt wanneer de trainingsdata noch geclassificeerd noch gelabeld is. Zoals de naam suggereert: geen hulp van de gebruiker aan de computer om te leren.
Het materiaal heeft geen labels, en de machine matcht kenmerken van de data en classificeert het. Door gebrek aan gelabelde trainingsets identificeert de machine patronen in de data die niet zo duidelijk zijn voor mensen.
Afbeelding: data-flair.training/
Hier is geen handmatige classificatie – makkelijkst voor mensen, moeilijkst voor computer en kan meer fouten veroorzaken. Het systeem vindt meestal niet de bedoelde output, maar onderzoekt de data en trekt relaties uit datasets om verborgen structuren te beschrijven uit ongelabelde data. Dus: patronen herkennen in data – unsupervised learning is extreem nuttig en helpt beslissingen nemen.
Semi-supervised learning
Semi-supervised learning verschilt van supervised en unsupervised: er zijn geen labels voor alle observaties of labels zijn aanwezig.
Bij semi-supervised worden zowel gelabelde (supervised) als ongelabelde (unsupervised) data gebruikt voor training. SSL is een mix: een kleine hoeveelheid gelabelde data, grote hoeveelheden ongelabelde data. De machine vindt features via gelabelde data en classificeert andere data met het basismodel. SSL-systemen verbeteren niet alleen leeraccuratesse, maar maken ook nauwkeurigere voorspellingen.
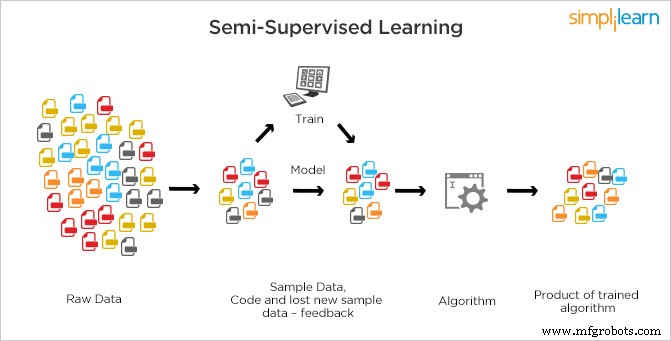
Dit is de meest gebruikte methode omdat labelkosten hoog zijn (deskundige mensen vereist). Het vereist relevante resources om te trainen, terwijl ongelabelde data doorgaans geen extra resources vereist. Vanwege gebrek aan labels in de meerderheid observaties maar aanwezige paar, zijn semi-supervised algoritmes de beste kandidaten voor modelbouwen.
Deze methoden profiteren van het idee dat ondanks onbekende groepsleden (onlabelde data meer algemeen is), informatie over parameters nog steeds in de gelabelde data zit en daar gevonden kan worden.
Reinforcement learning
Reinforcement learning is het dichtst bij hoe mensen leren. RL-algoritmes zijn een leermethode waarbij de machine herhaaldelijk interageert met zijn omgeving door nieuwe acties te construeren en fouten of beloning te ontdekken. Het gebruikt een positief of negatief beloningssysteem.
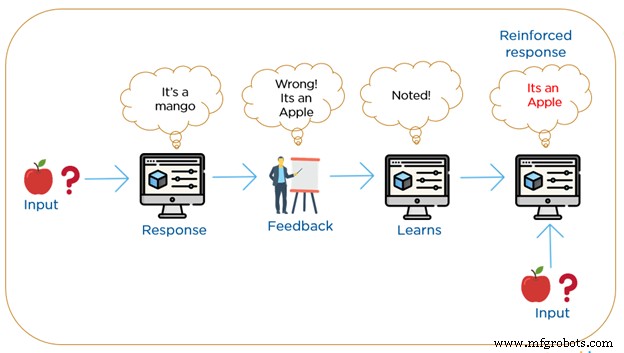
Trial-and-error zoeken met vertraagde beloning is de meest relevante kenmerk. De machine bouwt gedrag met observaties uit interactie met de omgeving en onderneemt acties die beloning maximaliseren of risico minimaliseren. Deze methode laat machines automatisch ideaal gedrag bepalen binnen een context om prestaties te verhogen. Bij reinforcement learning geen gelabelde materialen, maar simpele feedback: welke stap goed, welke fout – de versterkingssignaal.

Volgens de feedback-standaard herziet de machine geleidelijk de classificatie tot het correcte resultaat. Integratie van reinforcement learning is nodig om een bepaald precisieniveau in unsupervised learning te bereiken.
RL is waarschijnlijk het moeilijkst te produceren en uit te voeren in een zakelijke omgeving, maar wordt veel gebruikt voor zelfrijdende auto's.
Industriële technologie
- Freesmachines begrijpen: typen, functies en toepassingen
- Elementary Robotics haalt $13M Serie A binnen voor industriële machine learning & visie-oplossingen
- Machine Learning Versnelt Pijpleiding Veiligheid: Realtime Foutdetectie Bespaart $10M
- Machine Learning Inzetten voor MRO Supply Chain Optimalisatie
- Maximaliseer Bouwefficiëntie: 4 Vragen om Live Velddata te Ontgrendelen
- Data-analytics benutten voor efficiëntie en winstgevendheid voor olie- & gas-asset-eigenaren
- Polyurethaan ontdekken: typen, toepassingen en waarom het moderne industrieën domineert
- Freesmachines Begrijpen: Functies, Toepassingen en Voordelen
- Kepware vs. MachineMetrics: de optimale keuze voor industriële machinedataverzameling
- 9 Essentiële Machine Learning-toepassingen die u moet kennen
- AWS versterkt AI & Machine Learning Services met nieuwe features en integraties