



Data Lake vs. Big Data: De juiste aanpak kiezen voor industriële toepassingen
Data lake en big data zijn twee moderne termen die vaak misbruikt en onjuist gebruikt worden. Vanwege de geïmpliceerde grote datavolumes worden deze termen soms door elkaar gebruikt. Echter, data lake en big data zijn verschillend, zelfs als hun huidige definities nog niet volledig vaststaan.
Figuur 1. Moderne data kan afkomstig zijn uit veel bronnen en van verschillende typen zijn. Afbeelding gebruikt met toestemming van Analytics Vidhya
Laten we eerst kijken naar een korte historische context. In de late jaren 2000, met de explosieve groei van sociale mediaplatforms zoals Facebook en Twitter, begonnen veel datawetenschappers het potentieel van dergelijke platforms te realiseren voor het genereren van grote hoeveelheden waardevolle persoonlijke data. Als gevolg werden nieuwe softwareapplicaties ontwikkeld om dataverwerking en analyse te faciliteren. Een prominente voorbeeld is Apache Hadoop, essentieel een toolkit van open-source applicaties die big data-niveaus van informatie kunnen verwerken.
In het volgende decennium trad het Internet of Things (IoT) op de scene. Dit opende de deur voor miljoenen extra databronnen die inzicht konden geven in een persoons voorkeuren en patronen, terwijl ze ook informatie over het product zelf stuurden.
Gelijktijdig maakte machine learning belangrijke vooruitgang en vond meer praktische toepassingen in het industriële landschap. Dit resulteerde in een verhoogde behoefte om grote hoeveelheden data in de industrieën te hanteren, met name in geautomatiseerde processen.
Alle projecties wijzen erop dat de totale hoeveelheid beschikbare data in de wereld zal blijven uitbreiden met versnelde snelheden in de komende jaren. Ter referentie: in 2016 passeerde de wereld de mijlpaal van 1 Zettabyte aanjaagse internettraffic. Een Zettabyte is gelijk aan 1 biljoen Gigabytes.
Jaarlijkse internettraffic wordt verwacht 3 Zettabytes te overschrijden in 2021. Deze projecties, samen met de uitgebreide mogelijkheden van cloud computing, wijzen erop dat de waarde en toepassingen van big data (en data lakes) misschien pas net beginnen.
Wat is Big Data?
Als we kijken puur vanuit het perspectief van volume, is de definitie van big data een bewegend doel. Naarmate de hoeveelheid data en opslagruimte groeit, groeit ook de benchmark van wat als grote hoeveelheden informatie wordt beschouwd.
Vandaag de dag wordt een data-repository van 100 Terabyte of groter over het algemeen als big data beschouwd. Grote data-repositories zoals die van sociale mediaplatforms kunnen in de orde van verschillende Petabytes liggen.
Een andere referentie om big data te definiëren is wanneer de hoeveelheid informatie niet meer door traditionele computergereedschappen, zoals SQL, kan worden beheerd. Bijvoorbeeld: vandaag is het niet ongebruikelijk voor databases om jaarlijks 1 Terabyte te bereiken. Maar, met SQL-applicaties die krachtiger worden, kan deze grootte nog steeds beheerd worden; daarom worden ze meestal niet als big data beschouwd.
Big Data's 4V-model
Tot nu toe hebben we de definitie van big data bekeken vanuit het perspectief van volume. Er zijn drie andere belangrijke factoren om te overwegen: velocity (snelheid), variety (variëteit), en veracity (betrouwbaarheid). Samen met volume vormen ze het 4V-model.
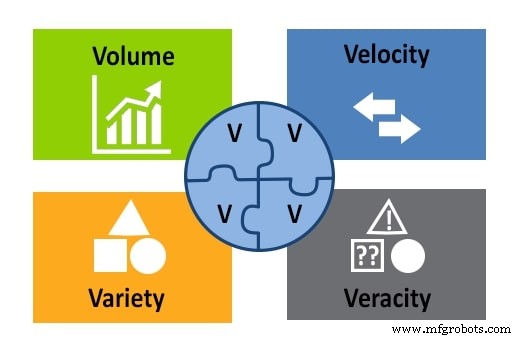
Figuur 2. Het 4V-model van big data: Volume, velocity, variety, en veracity. Afbeelding gebruikt met toestemming van APSense
Variety verwijst naar alle verschillende typen data die opgeslagen zijn in een big data repository: tekst, afbeeldingen, geluid, video, etc. Het verwijst ook naar het feit dat data uit meerdere bronnen kan komen.
Velocity is een belangrijke overweging in big data omdat de informatie constant binnenstroomt. Velocity gaat over de snelheid waarmee data verzameld, gegenereerd, en gedistribueerd wordt.
Veracity meet de nauwkeurigheid en kwaliteit van de data om te evalueren of een datawetenschapper het kan gebruiken voor analyse en voor het trekken van conclusies.
Nu we big data begrijpen, laten we data lakes bekijken voordat we duiken in hoe deze in een besturingssysteem te gebruiken.
Wat is een Data Lake?
Data lakes gecentraliseerde repositories van grote hoeveelheden ruwe data, wat informatie is die misschien wel of niet in de toekomst waardevol is en wiens doel nog niet 100% bekend is. Data lakes kunnen relationele en niet-relationele databases opslaan, samen met andere typen bestanden en entiteiten.
Hoewel de informatie in een data lake niet verwerkt of georganiseerd is, is het gestructureerd zodat alle inputs en outputs overwogen worden om een goede architectuur te creëren.
Data Lake vs. Big Data
Een data lake is een instantie van een big data-applicatie. Ze volgen de criteria beschreven in het 4V-model, met enkele toegevoegde particulariteiten. In termen van volume liggen data lakes gemiddeld aan de lagere kant van wat als big data beschouwd wordt.
Informatie in data lakes heeft variety, maar de voorwaarde is dat het alleen onverwerkte ruwe data is. In- en outputsnelheden zijn even relevant als bij elk modern systeem en data-kwaliteitsevaluaties worden uitgevoerd in een goed ontworpen data lake.
Industriële toepassingen voor data
Geavanceerde automatisering drijft een snelle toename in de hoeveelheid informatie die op de werkvloer wordt verwerkt. Dankzij dit zijn productie- en andere industriële processen nu het rijk van big data binnengedrongen, met diverse bedrijfsactiviteiten die nu tools zoals data lakes inzetten.
Een prominente voorbeeld is voorspellend onderhoud. De mogelijkheid om een mechanische of elektrische storing te voorspellen is zeer waardevol en kan substantiële besparingen op reparatiekosten opleveren. Data lakes zijn nuttige tools die informatie uit logbestanden, meerdere sensoren, en invoerapparaten kunnen compileren, wat gebruikt kan worden om trends te begrijpen en problemen te voorspellen.
Machine learning is een concept waarbij robots voorzien worden van informatie die hen kan helpen aanpassen aan veranderende externe condities. Het vastleggen van informatie is vergelijkbaar met voorspellend onderhoud, met de extra stap dat evaluaties en wijzigingen aan het proces automatisch aan de systeemcontroller worden doorgegeven. Machine learning data kan opgeslagen worden in een gestructureerde data lake.
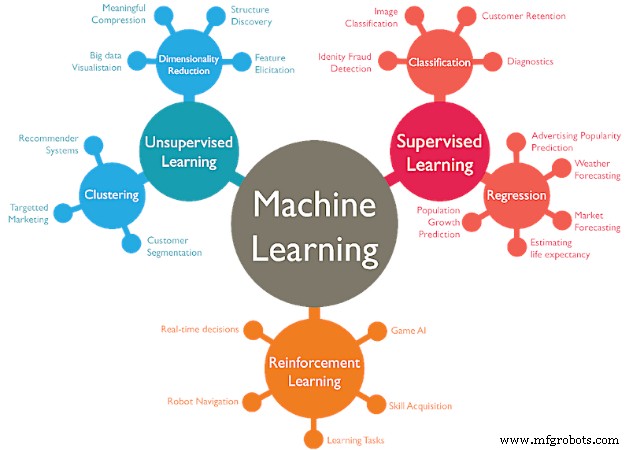
Figuur 3. Machine learning heeft verschillende strategieën die elk grote hoeveelheden data vereisen. Afbeelding gebruikt met toestemming van WordStream
Concluderend: een data lake is een instantie van een big data-applicatie. Deze twee manieren van data bekijken kunnen samenwerken. Door zowel big data als data lake te benutten, kan een control engineer storingen voorspellen, onderhoudsroutines creëren, de digitale transformatie van het faciliteit laten groeien, en nog veel meer.
Wat gebruik jij big data en data lakes voor in je werk?
Internet of Things-technologie
- GE lanceert Predix Cloud: Toegewijd platform voor industriële data & analytics
- Top 7 Industriële IoT-toepassingen die marktgroei drijven
- Cervoz-gids: betrouwbare flash-opslag selecteren voor industriële toepassingen
- Hoe verbonden sensoren en slimme processoren Industry 4.0 aandrijven
- Toekomstperspectief: Industrial IoT voortgang voor productie-excellentie
- Top 4 Uitdagingen voor de Industrial Internet of Things (IIoT)
- Zes sleutelprincipes voor high-impact sensor-gedreven IoT-applicaties bouwen
- RTUs benutten voor Big-Data-inzichten in industriële operaties
- Fundamenten leggen voor industriële data science succes
- Industrial IoT: Van Datavergaring naar Realtime Besluitvorming
- Kan Big Data Gezondheidsbudgetten Revolutieeren? Inzichten van Lux Research