



De Data Science Lifecycle beheersen: Een uitgebreide gids
Sinds de komst van big data heeft de moderne informatica nieuwe mogelijkheden en benchmarks voor verwerkingskracht bereikt. Tegenwoordig is het niet ongebruikelijk om toepassingen te vinden die datasets van 100 terabytes of meer produceren, wat als big data wordt beschouwd.
Met dergelijke grote hoeveelheden informatie aan de hand, is het gemakkelijk om ongestructureerd te raken en tijd te verspillen aan nutteloze content. Dit zijn twee redenen waarom het cruciaal is om een methodologie te volgen die de effectiviteit en efficiëntie van een big data-project vergroot.
Figuur 1. Moderne data science werkt met zeer grote datasets, ook wel big data genoemd.
De data science lifecycle biedt een framework dat helpt om big data-projecten te definiëren, verzamelen, organiseren, evalueren en implementeren. Het is een iteratief proces bestaande uit een reeks stappen die in een logische volgorde zijn gerangschikt, wat feedback en bijsturing vergemakkelijkt.
Hoe ziet de lifecycle-volgorde eruit? Het antwoord is: er is geen enkel universeel model dat iedereen volgt. Veel bedrijven die big data-projecten uitvoeren, passen de data science lifecycle aan hun bedrijfsprocessen aan, meestal met meer stappen. Ondanks dit hebben alle modellen en processtromen gemeenschappelijke delers. Dit artikel gebruikt het CRISP-DM-procesmodel, een van de eerste en populairste data science lifecycle-modellen.
Het CRISP-DM Model
CRISP-DM staat voor Cross Industry Standard Process for Data Mining. Het werd voor het eerst in 1999 gepubliceerd door ESPRIT, een Europees programma voor het stimuleren van onderzoek in informatietechnologie (IT). Het CRISP-DM-model bestaat uit zes stappen of fasen die het big data-project begeleiden. Het moedigt stakeholders aan om na te denken over het bedrijf door belangrijke vragen over het probleem te stellen en te beantwoorden.
Laten we de zes fasen van het CRISP-DM-model in detail bekijken.
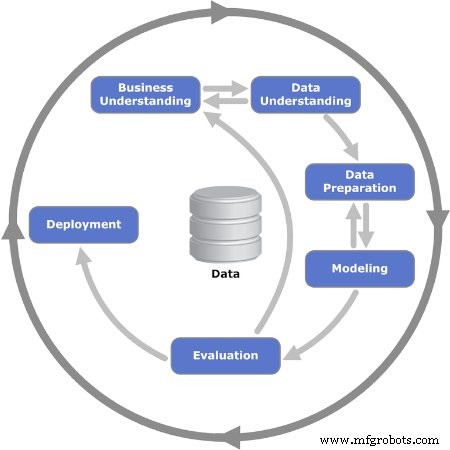
Figuur 2. De iteratieve zes fasen van het CRISP-DM-model worden getoond. Afbeelding gebruikt met toestemming van Kenneth Jensen
Fase 1: Bedrijfsbegrip (Business Understanding)
De eerste fase bestaat uit verschillende taken die het probleem definiëren en doelen vastleggen. Dit is het moment waarop de projectdoelstellingen worden vastgelegd met de focus op het bedrijf—of, met andere woorden, de klant. Normaal gesproken moet het team dat samengesteld is om aan een big data-project te werken, een oplossing leveren aan de klant, wat een ander gebied of afdeling binnen het bedrijf kan zijn.
Eenmaal de bedrijfsbehoefte of het probleem vastgesteld is, is de volgende stap het definiëren van succescriteria. Dit kunnen key performance indicators (KPI's) of service level agreements (SLA's) zijn, die objectieve middelen bieden om voortgang en voltooiing te evalueren.
Vervolgens moet de bedrijfssituatie geanalyseerd worden om risico's, rollback-plannen, contingentiemaatregelen, en, nog belangrijker, beschikbare middelen te identificeren. Een projectplan wordt opgesteld, inclusief mijlpalens en middelen.
Fase 2: Data Begrip (Data Understanding)
Eenmaal de fundamenten gelegd in de vorige fase, is het tijd om te focussen op de data. Deze fase begint met een initiële definitie van welke data nodig wordt geacht, en documenteert vervolgens specificaties erover: waar te vinden, type data, formaat, relaties tussen verschillende data-velden, etc.
Met de eerste documentatie klaar, is de volgende stap de uitvoering van de eerste data-verzamelrun. Dit biedt een nuttige momentopname van hoe de structuur zich vormt. Deze momentopname van informatie wordt vervolgens geëvalueerd op kwaliteit.
Fase 3: Data Voorbereiding (Data Preparation)
De derde fase versterkt de vorige fase en bereidt de dataset voor op modellering. Datavelden uit de eerste verzameling worden verder gecureerd, en informatie die onnodig wordt geacht, wordt uit de set verwijderd: dit heet het schoonmaken van de data.
Ook kan een specifiek stuk informatie afgeleid moeten worden uit andere beschikbare informatie; andere keren moet het gecombineerd worden. Met andere woorden: de data moet verwerkt worden om een eindformaat te produceren.
Fase 4: Modellering (Modeling)
De belangrijkste taak in deze fase is het selecteren van een algoritme om de verzamelde data te verwerken. In deze context is een algoritme een set van opeenvolgende stappen en regels geprogrammeerd in computergereedschap ontworpen voor big data-projecten.
Veel algoritmen kunnen gebruikt worden: lineaire regressie, beslissingsbomen, en support vector machines zijn enkele voorbeelden. Het kiezen van het juiste algoritme om het probleem op te lossen, vereist vaardigheden die ervaren data scientists hebben.
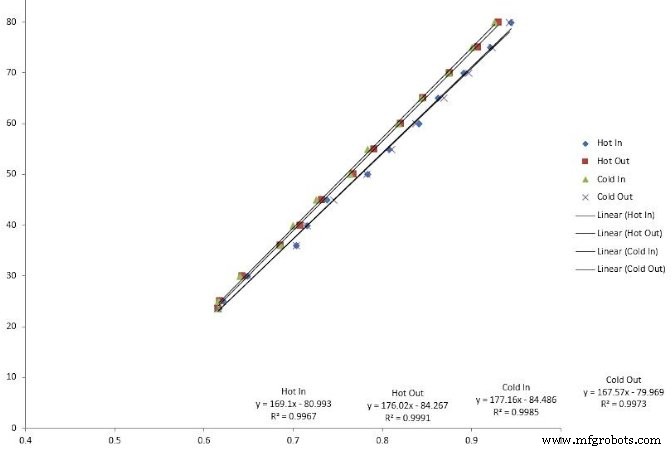
Figuur 3. Lineaire regressie is één type algoritme dat gebruikt wordt in big data-modellering.
De volgende stap is het coderen van het algoritme in de softwareapplicatie. Dit is ook het moment waarop de testfase gepland wordt, wat bestaat uit het toewijzen van specifieke datasets voor testen en validatie.
Fase 5: Evaluatie (Evaluation)
Soms is het moeilijk om direct een algoritme te kiezen. Wanneer dit gebeurt, voeren wetenschappers verschillende algoritmen uit en analyseren ze de resultaten om een eindbeslissing te nemen. Eenmaal de testfase voltooid, worden de resultaten beoordeeld op volledigheid en nauwkeurigheid.
Nog belangrijker: dit is een kans om te beoordelen of de resultaten leiden tot een oplossing. In het iteratieve model is dit een cruciaal knooppunt waar grote iteratie-reeksen gelanceerd kunnen worden, of een beslissing genomen kan worden om naar de finale fase te gaan.
Fase 6: Implementatie (Deployment)
Dit is het moment waarop het project van een testomgeving naar een live productieomgeving gaat. Het plannen van het implementatieschema en de strategie is zeer belangrijk om risico's en potentiële systeemdowntime te reduceren.
Hoewel het modeldiagram suggereert dat dit het einde van het project is, zijn er nog tal van vervolgstappen: monitoring en onderhoud. Monitoring is een periode van nauwkeurige observatie, ook wel hypercare genoemd, direct na de go-live. Onderhoud is een semi-permanent proces voor het onderhouden en upgraden van de geïmplementeerde oplossing.
Big data heet zo niet voor niets: er is een massive hoeveelheid data om door te parsen. Het implementeren van een van de data science lifecycle-modellen helpt beslissen welke informatie de moeite waard is om te bewaren en te gebruiken voor processen zoals voorspellend onderhoud.
Internet of Things-technologie
- Geluid Benutten: Datatransmissie Transformeren Buiten Smartphones
- AI en deep learning uitbesteden in de gezondheidszorg: Dataprivacy beschermen
- Voorspellend Onderhoud: Industry 4.0 Inzetten voor Ononderbroken Productie
- SIM-levenscyclus Stroomlijnen: Een Digitale Strategie voor CSP's
- Internet of Things democratiseren: Next-gen Satelliet IoT brengt universele, betaalbare connectiviteit
- De waarde van IoT-data ontsluiten: Veilige, inzichtgestuurde strategieën
- Domeinexperts bemachtigen met data science voor slimme manufacturing inzichten
- Waarom directe apparaatconnectiviteit de volgende mijlpaal is in de Industrial IoT
- Waarom analoge metingen plantprestaties drijven
- Tableau: Ruwe data omzetten in strategische inzichten
- Fundamenten leggen voor industriële data science succes