



Machine Learning integreren in PLCnext-controllers
Iedereen heeft inmiddels van Machine Learning gehoord en hoe het alles zal veranderen. Maar weinig mensen weten hoe ze moeten beginnen om dingen te veranderen. Ik hoop dat de stappen in deze blog je helpen om te begrijpen hoe je aan de slag kunt met je PLCnext-controller. In deze blog ga ik het hebben over het trainen van je eerste ML-model, het converteren naar de ONNX-standaard en het uitvoeren van inferentie op een PLCnext-controller. Om het niet te overweldigend te maken, gebruik ik de bekende Iris-dataset om ons model te bouwen.
Voordat we beginnen, is het belangrijk om duidelijk te hebben wat we proberen te bereiken. Daarom geef ik een korte uitleg over de onderwerpen die in deze blog worden behandeld. Mijn referenties vind je aan het einde.
Inleiding tot Machine Learning
Wat is Machine Learning?
We beginnen met uitleggen wat machine learning is. De essentie is dat we proberen patronen in datasets te vinden met behulp van statistiek en algoritmen. We onderscheiden drie hoofdtypen: gesuperviseerd, ongesuperviseerd en reinforcement learning. Gesuperviseerd leren is vandaag de dag het meest gebruikt en wij gebruiken dat ook in deze blog. Bij gesuperviseerd leren labelen we de data en vertellen we de machine precies welke patronen we zoeken.
Bij ongesuperviseerd leren labelen we onze data niet en laten we de machine zelf patronen ontdekken; omdat deze techniek minder duidelijke toepassingen heeft, is het minder populair.
Tot slot bij reinforcement learning: een algoritme leert door trial and error een gesteld doel te bereiken. Het probeert veel dingen en krijgt een beloning of straf afhankelijk van of de actie goed of slecht was. Googles AlphaGo is een beroemd voorbeeld.
De Iris-bloem dataset
Volgens Wikipedia is de Iris-bloem dataset:
Oké, maar hoe ziet het eruit?
In de Iris-dataset zijn 5 velden: sepal length, sepal width, petal length, petal width en de variëteit van de Iris-bloem. Ons doel is om het type Iris-bloem te voorspellen wanneer we de vier metingen kennen. We trainen het model dus om het bloemtype te classificeren. Dit type machine learning heet classificatie.
Machine learning kan ook gebruikt worden om een waarde in de dataset te voorspellen; dat heet regressie en gebruikt andere algoritmes dan classificatie.
Het algoritme
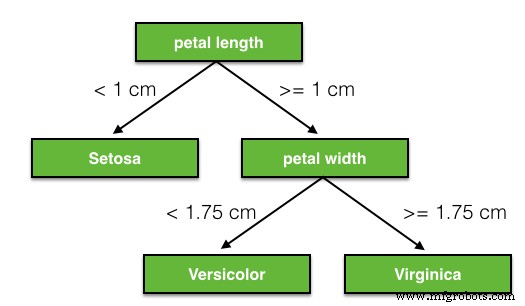
Vandaag gebruiken we de Decision Tree Classifier, niet omdat het perfect is voor de taak, maar omdat het heel intuitief is en begrepen kan worden zonder ingewikkelde wiskunde. Hier vind je een voorbeeld van een beslissingsboom voor onze Iris-dataset.
ONNX
Machine Learning-modellen komen in een grote verscheidenheid aan formaten en moeten op veel verschillende hardware draaien met verschillende versnellingmethoden. De Open Neural Network Exchange (ONNX) probeert dat probleem te mitigeren. Het wordt gebruikt in Open Office, Azure en talloze andere toepassingen over de hele waereld – waarschijnlijk ook op het apparaat waarop je dit leest.
Om ONNX-modellen te draaien heb je de ONNX runtime nodig, wat uitdagingen met zich meebrengt, vooral op ARM-processors. Met de meegeleverde Docker-images zou het echter goed moeten gaan.
Technische walkthrough
Vereisten
Ik gebruik een AXC F 2152-controller met firmware 2021.0 LTS en een Ubuntu 20.04 VM om het model te trainen. De scripts voor training en inferentie zijn meegeleverd, maar de opzet van de Ubuntu VM valt buiten de scope van deze blog. Je vindt goede uitleg over het installeren van de benodigde Python-pakketten; alle gebruikte pakketten moeten correct installeren met pip3.
Op de PLCnext-controller heb je een container-engine nodig. Een goede uitleg van de procedure vind je hier.
Een vergelijkbare procedure met de AXC F 3152 is ook mogelijk.
Je hebt minimaal enige ervaring met Python en containers nodig voor deze blog.
Het model trainen
Download de inhoud van deze GitHub-repository en zorg dat alle benodigde pakketten geïnstalleerd zijn.
Het eerste script dat we draaien is het train-script waarin we ons model fitten op de Iris-dataset. Hieronder een codefragment uit dat script. Dit script creëert een .onnx-bestand met ons getrainde model.
# Splits de dataset in trainings- en testset
iris = load_iris()
X, y = iris.data, iris.target
X_train, X_test, y_train, Y_test = train_test_split(X, y)
# Definieer het model en fit met trainingsdata, print informatie over het model
clr = DecisionTreeClassifier()
clr.fit(X_train, y_train)
print(clr)
# Converteer het model van sklearn-formaat naar ONNX (Open Neural Network Exchange)
initial_type = [('float_input', FloatTensorType([None, 4]))]
onx = convert_sklearn(clr, initial_types=initial_type)
with open("decision_tree_iris.onnx", "wb") as f:
    f.write(onx.SerializeToString())
Inferentie op Ubuntu
Controleer je model door het op je ontwikkelmachine uit te voeren. Als je het inferentie-script draait, zou je 2 integers moeten krijgen die overeenkomen met een type Iris-bloem.
import numpy as np
import onnxruntime as rt

X_test = np.array([[5.8,4.0,1.2,0.2],[7.7,3.8,6.7,2.2]])

sess = rt.InferenceSession("decision_tree_iris.onnx")
input_name = sess.get_inputs()[0].name
label_name = sess.get_outputs()[0].name
pred_onx = sess.run(
    [label_name], {input_name: X_test.astype(np.float32)})[0]
print(pred_onx)

output : [0 2]
Inferentie op PLCnext
Open je favoriete sFTP-client en plaats het .onnx-bestand en inference.py in /opt/plcnext/onnx op je PLCnext-controller. Voer daarna het volgende commando uit als root:
balena-engine run -it --name onnx -v /opt/plcnext/onnx/:/app pxcbe/onnx-runtime-arm32v7
Draai het Python-inferentie-script met:
cd /app
python3 /app/inference.py
Als alles goed ging, krijg je dezelfde output als met de inferentie op je Ubuntu VM! Gefeliciteerd, je hebt het bereikt. Nu ga dingen veranderen!
Hoe implementeer je dit in een applicatie?
Eigenlijk zijn we nog niet klaar. Iris-bloemen classificeren is leuk, maar ik kan me geen meerdere toepassingen hiervoor voorstellen op een logische controller. Je moet je eigen model bedenken en een API dafür creëren zodat je er inferentie mee kunt doen. Je kunt kiezen om data aan het model te leveren via OPC UA of een custom REST-endpoint bouwen. Op welke manier dan ook, je moet meer code schrijven dan wat ik hier gegeven heb.
Rekening houdend met het bouwen van de images letterlijk dagen en een nacht zonder slaap heeft gekost, raad ik je aan je image te bouwen op basis van de meegeleverde image. In de referenties vind je een goede bron voor het bouwen van een Python-container-app.
Referenties:
Industriële technologie
- Revolutionaire assetbetrouwbaarheid: Machine Learning voor voorspellend onderhoud
- De Evolutie en Productie van Naaimachines: Van 19e-Eeuwse Innovatie tot Moderne Automatisering
- Machine Learning Versnelt Pijpleiding Veiligheid: Realtime Foutdetectie Bespaart $10M
- Binnenkijken in de Rol van AI-onderzoekers & ML-engineers bij JPMorgan
- Machine Learning Inzetten voor MRO Supply Chain Optimalisatie
- AI en Machine Learning in inkoop omarmen: Kansen, uitdagingen en best practices
- Hoe AI en machine learning CNC-bewerking revolutioneren
- Top 4 industrieën gerevolutioneerd door Machine Learning
- 9 Essentiële Machine Learning-toepassingen die u moet kennen
- Nauwkeurige Batterij Levensduur Voorspelling met AI – DOE Argonne Studie
- Machine Learning Op AWS Meesteren: Een Uitgebreide Gids