



Zakelijk succes versnellen: AI & ML lossen realtime data-uitdagingen op
Data snel actiebaar maken creëert moeilijke uitdagingen voor de oude data management-orde.
Drie nieuwe rapporten van Gartner brengen de toenemende urgentie voor ondernemingen van het bouwen van waarde-genererende operationele applicaties geïnfuseerd met AI en ML in scherp focus – of risico lopen voor altijd achter te blijven.
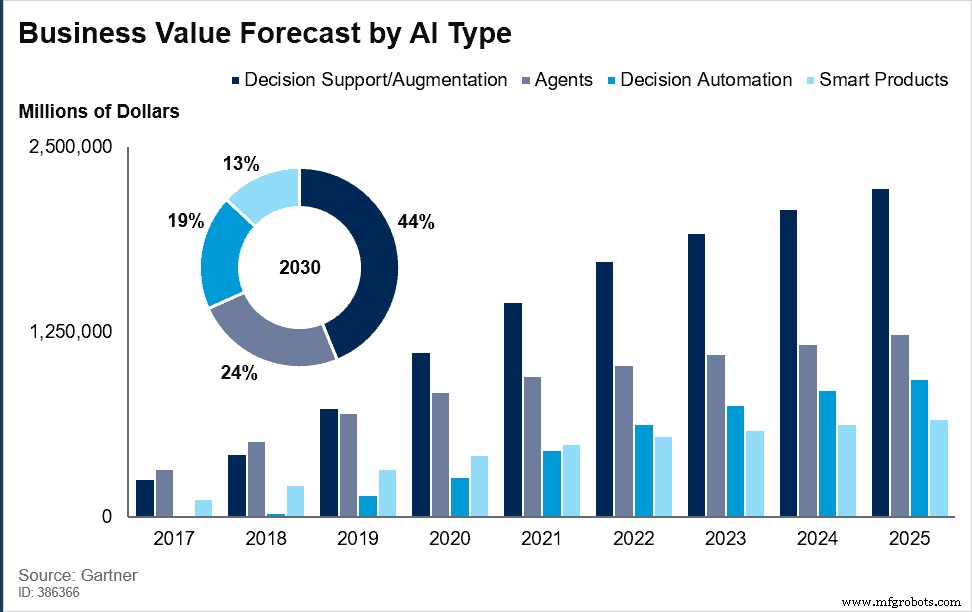
Urgentie Bouwer #1: In zijn nieuwste AI zakelijke waarde voorspelling, zegt Gartner dat AI augmentatie $2,9 biljoen aan zakelijke waarde zal creëren in 2021. Dat is in slechts één jaar.
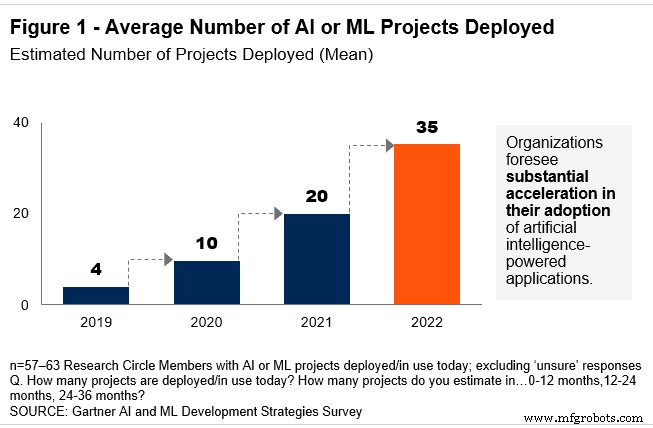
Urgentie Bouwer #2: Gartner's AI en ML Ontwikkelingsstrategie-studie vindt dat leidende organisaties verwachten hun AI/ML-projecten massaal te verhogen – van een gemiddelde van vier dit jaar naar 35 bij 2022.
Urgentie Bouwer #3: In zijn "Voorspellingen 2019: Data & Analytics Strategie" rapport, zegt Gartner, "Effectief datamanagement is kritieker dan ooit. Terwijl sommige bedrijven controle over hun data hebben genomen en het omgezet in een wapen voor het beveiligen van marktdominantie, worstelen velen anderen met een kwestie die de remmen op intelligentiecoördinatie zet: silos."
Zie ook: Hoe AI-implementatie te versnellen om CI-voordelen sneller te bereiken
Gartner's "leidende organisaties" zijn degenen die vooraan lopen in de race om delen te grijpen van die $2,9 biljoen aan zakelijke waarde die zal vloeien uit AI, ML en IoE-initiatieven rond beslissingsondersteuning, realtime beslissingsautomatisering en AI-geaugmenteerde intelligentie, onder andere.
Wat houdt bedrijven tegen?
Gesiloiseerde data isn't het enige ding dat inspanningen om IoE-applicaties te bouwen en ML en AI-projecten te implementeren ondermijnt. Ongelijke, legacy-systemen ongeschikt om tijdreeksdata geassocieerd met IoT, en realtime operaties te hanteren, kunnen ook verwarden.
Waar staat jouw organisatie in de race om waarde te realiseren? Hoe help jij de weg glad te maken naar het implementeren van AI of ML-projecten en IoE-applicaties? Als je zoals veel bedrijven bent, worstelen je inspanningen met diverse sleuteluitdagingen, beginnend met gesiloiseerde data.
De onmogelijkheid om data samen te brengen uit uiteenlopende bronnen en een holistische weergave te renderen is een hoofddriver voor waarom sommige bedrijven worstelen om bij te blijven, zelfs voordat ze hun Internet of Everything (IoE) applicatievereisten overwegen.
Jarenlang hebben ze gecommitteerd aan data silo's gedwongen op hen door generaties van industrie-specifieke, smalle-functie SaaS en enterprise cloud-applicaties. Maar nu raken ze de analytische limieten van gesegregeerde data en ontdekken ze dat ze hun data niet holistisch kunnen analyseren of erop kunnen handelen zoals het bestaat of het gemakkelijk implementeren in nieuwere generatie applicaties.
Data maken tot het zwaartepunt
Om te slagen, moeten alle ML en AI-inspanningen gegrondvest zijn in data. We bekijken elke procesautomatisatievereiste door een datalens eerst. Het is het zwaartepunt voor alles wat we doen, elk proces dat we automatiseren, en elke realtime beslissing of actie die we mogelijk maken.
Terwijl we geoptimaliseerd zijn voor sensor-gegenereerde tijdreeksdata, maakt het eigenlijk niet uit wat voor type data het is, wat de bron is, of in wat voor volume of velocity – data is onze root cause. Het bouwen van de data-automatiseringsbasis voor data-agnostische applicaties stelt silo-busting data-unificatie-vooruitgang in de gefractureerde wereld van enterprise SaaS in staat.
We denken ervan als een omnidata benadering – iets waar je meer over zult horen naarmate datamanagementvereisten voor sensornetwerken omnidata-voordelen elders in de onderneming mogelijk maken.
Heersende marktplaatsbenaderingen volgen deze edict zelden. Praat met een typisch IoT-bedrijf, bijvoorbeeld, en ze zullen geen goed verhaal hebben over hoe ze mensen in de vergelijking brengen. Ze gaan allemaal over dingen. Op dezelfde manier praten locatiedataservices en workforce management providers een goed verhaal over het tracken van mensen en werknemers maar hebben weinig credibiliteit voor het integreren van dingen.
Dit is een reden waarom IoE veel meer aanwezig is in onze communicatie dan IoT. Meeste enterprise operationele problemen omvatten mensen en dingen in gelijke mate. Van een dataperspectief is er geen verschil of bias.
De oude data management-orde is voorbij
Data operationalisatie creëert enorme nieuwe uitdagingen voor de oude data management-orde. Of ze het weten of niet, ondernemingen betreden een "post database management system (DBMS)" wereld. Ze vinden het steeds moeilijker – zo niet onmogelijk – om data-in-motion use cases in te hakken in starre, legacy DBMS-infrastructuur.
Data-eisen voor softwareapplicaties zijn dramatisch veranderd. Zowel gebruikers als machines creëren meer data om zakelijke logica te drijven met technieken zoals realtime data-analyses en machine learning.
Traditioneel werd al data van een applicatie opgeslagen in gecentraliseerde of kantoor-centrische, relationele databases. Maar dit schaalt niet voor de sensor-gedreven, tijdreeksdata-explosie waarop realtime operaties en intelligentie afhankelijk zijn.
Om echte data-gedreven oplossingen te bouwen, zijn de engineering en onderhoudslasten onomkeerbaar gecompliceerd. We zijn gegaan van een handvol subsystemen tot dozijnen subsysteem die de expertise van duurdere big data engineering teams vereisen.
Use Cases begrijpen
Simpelweg IoE, ML en AI-gerelateerde use cases verbeelden en begrijpen is een andere grote uitdaging die bedrijven tegenhoudt.
Ongeveer 42% van respondenten op Gartner's AI/ML-ontwikkelingsenquête noemde use case identificatie als hun tweede grootste uitdaging (na een tekort aan vaardigheden). We zien dit, keer op keer.
Andere sleuteluitdagingen omvatten schaalbaarheid, samen met onbuigzame, legacy-systemen die niet om kunnen gaan met tijdreeksdata of grote volumes hoog-snelheidsdata van uiteenlopende bronnen.
Eén ruggengraat om ze allemaal te regeren
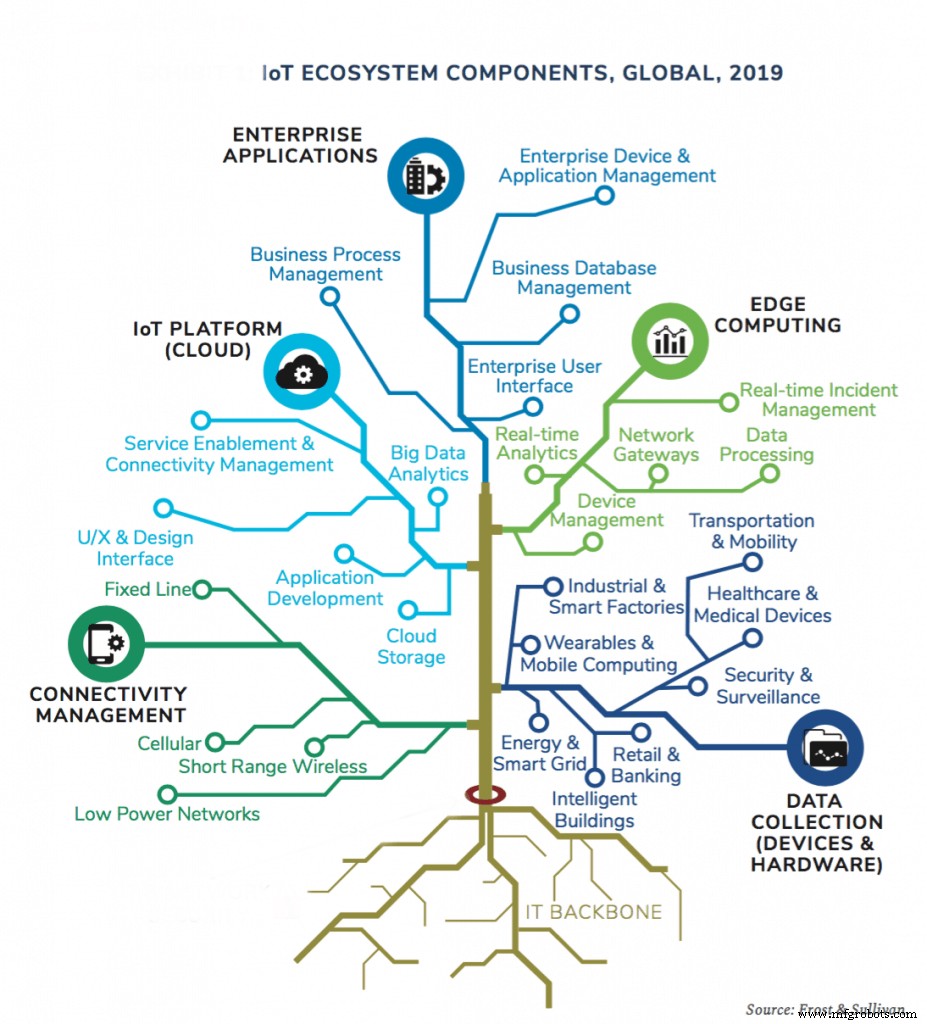
Gegeven deze reeks uitdagingen, experimenteren steeds meer bedrijven met het gebruik van een "enkele ruggengraat" data-automatiseringsbasis voor het bouwen van IoE-applicaties. Dit vereist een open, flexibel platform voor het bouwen van realtime, schaalbare, data-automatiserings- en AI-oplossingen die schaalbare datainname, normalisatie en verrijking kunnen hanteren samen met realtime zakelijke logica, dataopslag en beslissingsanalytics.
Een data ruggengraat-benadering stelt ontwikkelaars in staat om zich te richten op het bouwen van unieke zakelijke en gebruikerswaarde in hun oplossing, in plaats van te proberen alle uses van data te anticiperen om te passen binnen oudere, meer starre DBMS-infrastructuur.
Ondernemingen hebben systemen nodig die hen in staat stellen sensordata te consumeren bij variërende volumes en velocities, met elk type of combinatie van inputs en outputs. En ze zouden de mogelijkheid moeten hebben om dergelijke mogelijkheden on-premises, in de cloud, op de Edge of een hybride versie te implementeren.
Dit lost of vermijdt een menigte problemen op, van gesiloiseerde data en beperkte schaalbaarheid tot de uitdagingen van het bouwen van meerdere applicaties zonder de data-foundation telkens opnieuw uit te vinden. En het zal een snellere pad naar waarderealisatie bieden.
Internet of Things-technologie
- Cisco onthult Catalyst 5G Industriële Routers voor naadloze verbinding van enterprise en edge-netwerken
- Ondernemingsgrenzen Doorbreken: Verbonden Platforms Benutten Voor Naadloze Samenwerking
- Real-time IIoT-data drijft veiligheid, efficiëntie en ROI in magazijnen en productie
- IoT in de Edge-era: Groei, data, beveiliging en partnerstrategie
- Hyperconvergerde secundaire opslag: Unified Data Management voor Enterprise IoT drijven
- Digitale Transformatie Versnellen: Cisco & IBM's Edge-to-Cloud IoT-platform
- Verantwoorde en betrouwbare AI bouwen: een gids voor uitlegbaarheid, accountability en ethiek
- IoT-data benutten voor productie-excellentie
- Industrie 4.0 verhogen: Edge-analytics benutten voor slimmere, snellere productie
- IoT en AI: Transformatie van dagelijks leven en industrie
- IIoT Trends & Uitdagingen: Data Overload, Productieshifts en het Vaardigheden Tekort