



BrainChip lanceert Akida neuromorfe development-kits voor edge AI
BrainChip, een toonaangevende neuromorfische computing-IP-provider, introduceerde twee nieuwe development-kits met zijn Akida neuromorfische SoC op de recente Linley Fall Processor Conference. De kits komen in een x86 Shuttle PC-formaat en een Arm-gebaseerd Raspberry Pi-ontwerp, wat ontwikkelaars kant-en-klare platforms geeft voor het bouwen en testen van spiking neural network (SNN)-applicaties. Akida-silicium is ook beschikbaar voor integratie in custom-ontwerpen.
Akida's neuromorfische architectuur levert ultra-laagstroom AI door de hersens event-gedreven verwerking na te bootsen. In tegenstelling tot conventionele deep-learning-modellen, transmitteren SNNs informatie via discrete spikes die zowel spatiale patronen als temporele sequenties coderen. Dit event-domein is ideaal voor edge-apparaten die real-time, stroom-bewuste inferentie van sensor-stromen vereisen.
Naast native SNN-workloads, kunnen BrainChip's neural processing units (NPUs) convolutionele neurale netwerken (CNNs) uitvoeren na conversie naar het event-domein. De conversie, uitgevoerd door de MetaTF-software-flow, behoudt CNN-functie-extractie terwijl on-chip-leren via spike-timing-afhankelijke plasticiteit mogelijk maakt – wat de noodzaak voor cloud-gebaseerde heropleiding elimineert.
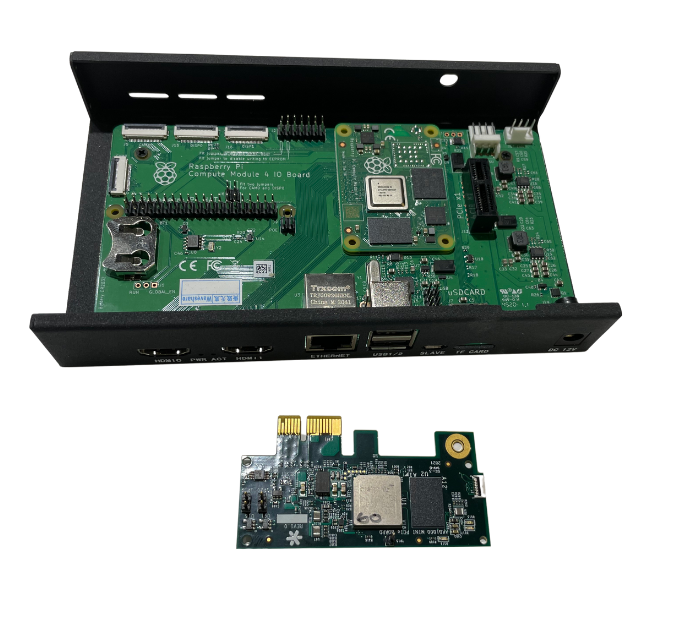
BrainChip's development-boards zijn beschikbaar voor x86 Shuttle PC of Raspberry Pi. (Bron: BrainChip)
"Akida is klaar voor morgen's neuromorfische technologie, maar het lost al vandaag de edge AI-uitdagingen op," zei Anil Mankar, BrainChip co-founder en chief development officer, tegen EE Times. "Onze runtime-software verwijdert de leercurve rond SNNs en het event-domein, wat ontwikkelaars vertrouwd met TensorFlow of Keras in staat stelt om modellen te porten en stroom en nauwkeurigheid direct op onze hardware te evalueren."
Mankar legde uit dat CNNs uitblinken in functie-extractie uit grote datasets. Door CNN-lagen te converteren naar event-gebaseerde operaties – behalve de finale classificatielaag – behoudt Akida deze capaciteit terwijl het spike-timing-leren toevoegt. Native SNNs kunnen one-bit-precisie gebruiken, terwijl geconverteerde CNNs typisch 1-, 2- of 4-bit-spikes emploteren. BrainChip's kwantisatietool helpt ontwerpers de juiste bit-breedte per laag te kiezen. Bijvoorbeeld, een MobileNet V1-model gekwantiseerd tot 4 bits bereikte 93,1% nauwkeurigheid op een 10-klasse-classificatietaak.
Conversie naar het event-domein levert ook significante stroombesparing op door sparsiteit. In het event-domein genereren alleen non-zero-activatiewaarden spikes, en de NPU verwerkt alleen die events. Voor een typische CNN zijn ongeveer de helft van de activaties nul na ReLU, dus de event-gebaseerde implementatie vermindert het aantal MAC-operaties aanzienlijk, wat stroomverbruik verlaagt.
Functies zoals convolutie, point-wise-convolutie, depth-wise-convolutie, max-pooling en global-average-pooling kunnen allemaal naar het event-domein vertaald worden. Het volgende diagram illustreert de reductie in MAC-operaties voor een object-classificatietaak: donkerblauw vertegenwoordigt de traditionele CNN, lichtblauw toont de event-domein Akida-implementatie, en groen geeft verdere activiteits-regularisatie aan.
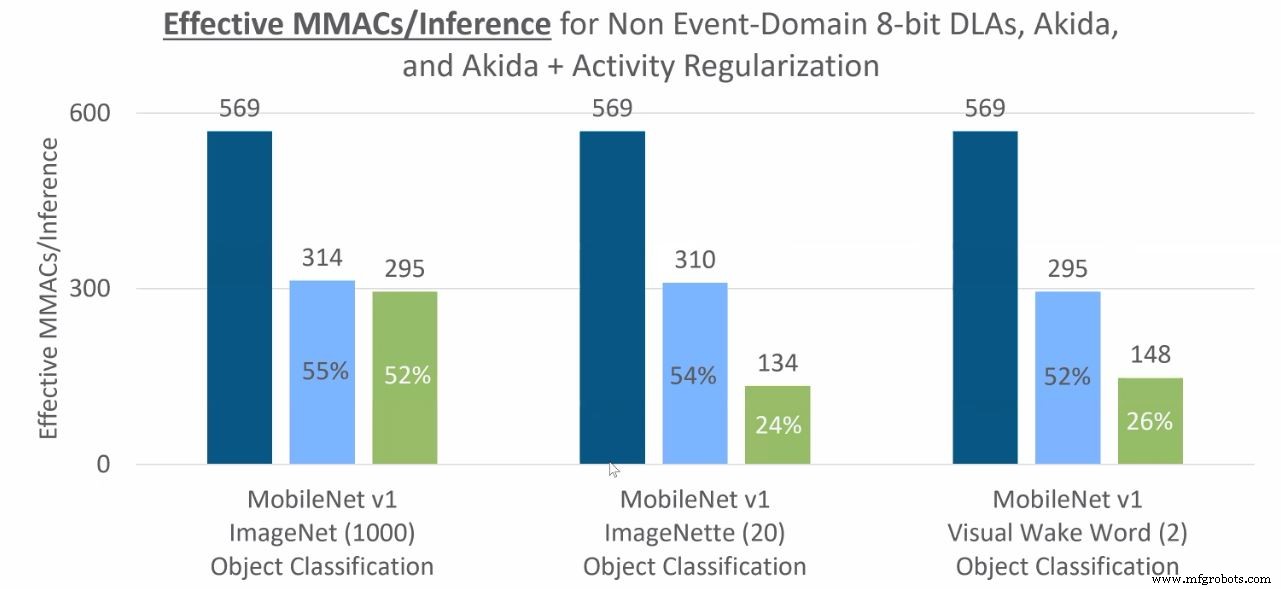
MAC-operaties vereist voor object-classificatie-inferentie (donkerblauw is CNN in non-event-domein, lichtblauw is event-domein/Akida, groen is event-domein met verdere activiteits-regularisatie). (Bron: BrainChip)
In een real-world-benchmark, verbruikte een keyword-spotting-model draaiend op het Akida-bord na 4-bit-kwantisatie slechts 37 µJ per inferentie (equivalent aan 27.336 inferenties per seconde per watt). Het model bereikte 91,3% nauwkeurigheid tijdens het opereren op een bescheiden 5MHz-klok.
Sensor-agnostisch
BrainChip's NPU-IP en Akida-chip zijn netwerk-agnostisch en ondersteunen een breed bereik aan sensoren. Of het nu beeld, audio, reuk, smaak, of tast-data verwerkt, dezelfde hardware kan zowel CNNs (via conversie) als native SNNs aan.
Elke NPU-node bevat 100 kB lokaal SRAM voor parameters, activaties en event-buffers, en tot vier nodes kunnen geclusterd worden in een mesh-netwerk. Netwerken die meerdere nodes beslaan, communiceren direct tussen lagen zonder CPU-interventie, hoewel bepaalde non-CNN-workloads nog steeds CPU-ondersteuning vereisen. De IP kan schalen tot 20 nodes, wat grotere modellen in staat stelt om in meerdere passes op kleinere hardware te draaien.
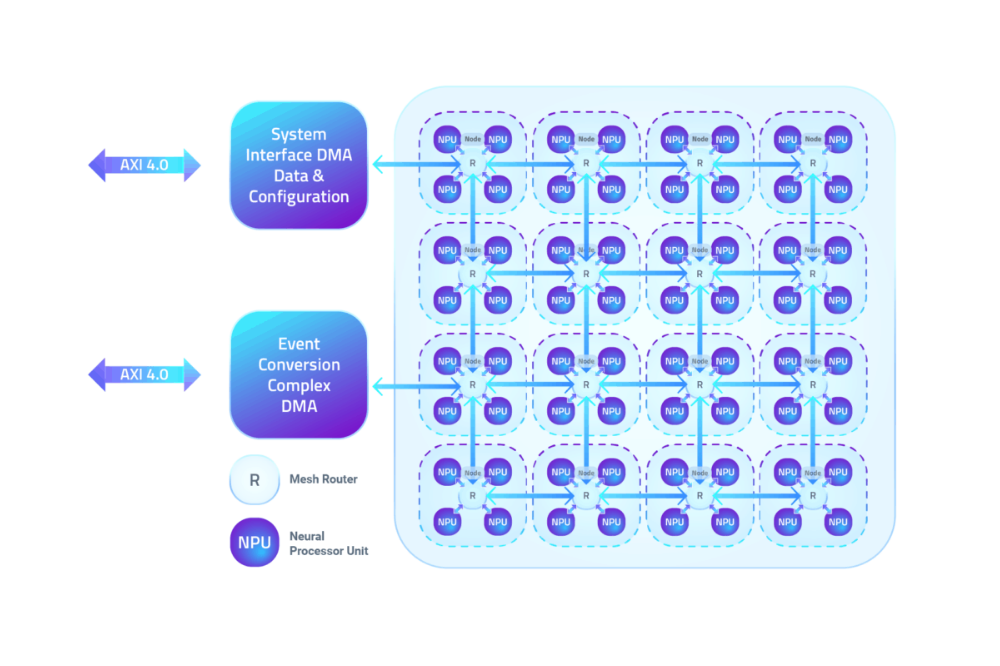
Nodes van vier BrainChip NPU's zijn verbonden door een mesh-netwerk. (Bron: BrainChip)
Een demovideo toonde Akida in een voertuigcabine: één chip detecteerde simultaan de bestuurder, herkende het gezicht van de bestuurder, en identificeerde hun stem. Keyword-spotting vereiste slechts 600 µW, gezichtsherkenning 22 mW, en visuele wake-word-inferentie 6-8 mW – wat de chip's geschiktheid voor automotive-edge-AI demonstreert.
Rob Telson, BrainChip's vice president of worldwide sales, merkte op dat Akida's 28nm TSMC-proces een sterke baseline biedt, en IP-klanten kunnen naar fijere nodes gaan voor nog grotere stroom-efficiëntie. Hij benadrukte ook on-chip-leren voor gezichtsherkenning: met voldoende neuronen in de finale laag kan een systeem groeien van het herkennen van 10 gezichten naar meer dan 50 met one-shot-leren, wat cloud-afhankelijkheid elimineert.
Early Access Klanten
BrainChip werkt 55 medewerkers over zijn hoofdkantoor in Aliso Viejo, CA, en ontwerpkantoren in Toulouse, Frankrijk; Hyderabad, India; en Perth, Australië. Het bedrijf houdt 14 octrooien, beurst op de Australische beurs, en is gelist op de VS OTC-markt.
Early-access klanten omvatten NASA, automotive, militair, aerospace, medisch (bijv. reukende COVID-19-detectie), en consumer-elektronica-bedrijven. Renesas heeft een 2-node Akida NPU-IP gelicenseerd voor integratie in toekomstige microcontroller-eenheden gericht op sensordata-analyse in IoT-implementaties.
Akida-IP en silicium zijn nu beschikbaar.
>> Dit artikel was oorspronkelijk gepubliceerd op onze zuster-site, EE Times.
Gerelateerde Inhoud:
- Startup pakt 1000 RISC-V-kernen in AI-accelerator-chip
- AI-chip richt zich op laagstroom-edge-apparaten
- AI-ingeschakelde SoCs hanteren meerdere videostromen
- Beveiliging bouwen in een AI-SoC met CPU-functies met extensies
- Microcontroller-architecturen evolueren voor AI
Voor meer Embedded, abonneer je op Embedded’s wekelijkse e-mail-nieuwsbrief.
Ingebed
- Event Flag Groups in Nucleus SE: Een Introductie tot Configuratie en API-Gebruik
- Neuromorfe chips: de volgende grens voor AI-prestaties
- Kontron onthult COM HPC: een nieuwe high-performance embedded-computing-standaard
- STMicroelectronics lanceert $99 LoRa Development Kits voor Rapide IoT Implementatie
- STMicroelectronics lanceert AutoDevKit: versnellen van automotive ECU-ontwerp
- RSL10 Mesh Development Kit maakt ultra-laagstroom BLE-netwerken mogelijk
- ams lanceert NanoVision en NanoBerry kits aangedreven door 1mm×1mm NanEyeC sensor
- Waarom Linux De Cloud Aandrijft: Een Uitgebreide Gids
- 10 Essentiële Cloud Computing Voordelen Voor Moderne Bedrijven
- Cloud Computing vs On-Premise: Welke Infrastructuur Past Bij Uw Bedrijf?
- C# Events: Gebruikersacties en Systeemnotificaties Afhandelen