



IBM's nieuwe low-precision AI-chip haalt 25,6 TFLOPS training & 102,4 TOPS inferentie
Op de 2024 ISSCC onthulde IBM Research een 7 nm-prototype dat jaren aan werk op low-precision AI-training en inferentie belichaamt. De chip levert 16-bit en 8-bit training, alsook 4-bit en 2-bit inferentie – ver onder de industrienorm van 32-bit training / 8-bit inferentie.
Het verlagen van numerieke precisie snijt compute- en stroomvereisten, maar IBM introduceerde ook verschillende architecturale optimalisaties die de efficiëntie verder boosten. De sleuteluitdaging is om precisie te verminderen zonder nauwkeurigheid te schaden – een probleem dat IBM jarenlang van algoritmisch niveau aanpakt.
IBM's AI Hardware Center, gelanceerd in 2019, streeft ernaar om AI-compute-prestaties met 2,5× per jaar te verhogen, met als doel een 1.000× verbetering in FLOPS/W voor 2029. Zulke ambitieuze doelen worden gedreven door de explosieve groei van AI-modellen – met name trillion-parameter NLP-systemen – en de groeiende koolstofvoetafdruk van hun training.
Op het prototype bereikt de 4-core chip 25,6 TFLOPS voor 8-bit training, terwijl het 102,4 TOPS levert voor 4-bit integer inferentie (beide gemeten bij 1,6 GHz en 0,75 V). Het verlagen van de klok naar 1 GHz en de spanning naar 0,55 V verbetert de stroom-efficiëntie tot 3,5 TFLOPS/W (FP8) of 16,5 TOPS/W (INT4).
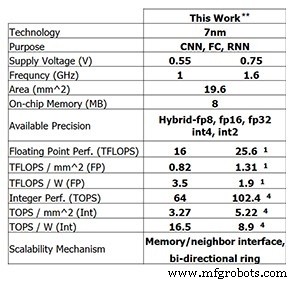
Prestaties van IBM Research's testchip (Afbeelding: IBM Research) **Gerapporteerde prestaties bij 0% sparsity. (1) FP8. (4) INT4.
Low-precision training
Deze prestatie bouwt voort op jaren algoritmisch werk op low-precision training en inferentie-technieken. De chip is de eerste die IBM's hybride FP8-formaat ondersteunt, geïntroduceerd op NeurIPS 2019, wat 8-bit training mogelijk maakt terwijl de compute van 16-bit training gehalveerd wordt zonder resultaten in te boeten.
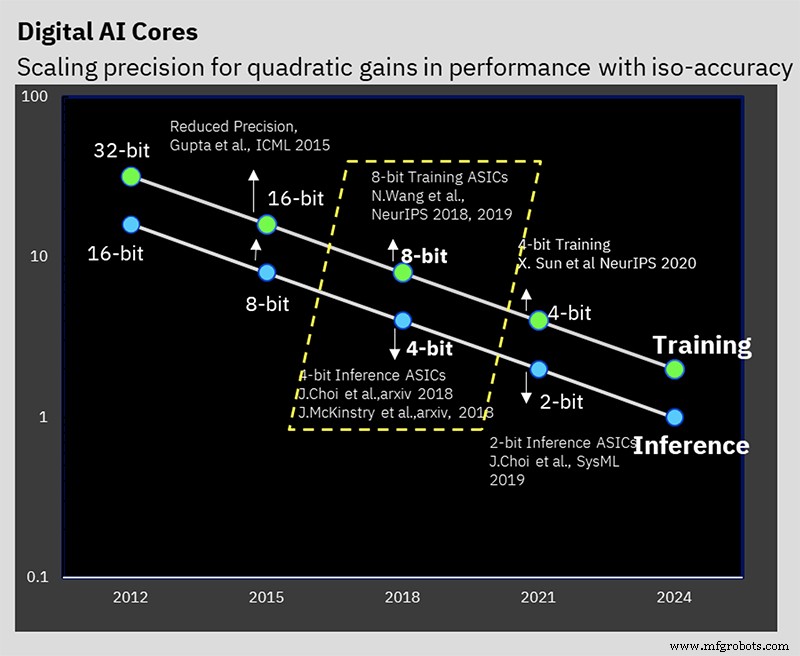
IBM Research werkt al jaren aan het oplossen van het probleem van nauwkeurigheid behouden bij precisieverlaging (Afbeelding: IBM)
"Low-precision training is uitdagend, maar 8-bit training is haalbaar met de juiste number-formats," aldus Kailash Gopalakrishnan, IBM Fellow en senior manager voor accelerator-architecturen en machine learning. "De juiste numerieke formaten, toegepast op de juiste tensors, zijn kritiek."
Hybride FP8 combineert twee formaten: één voor gewichten en activaties in de forward-pass, en een ander voor gradienten in de backward-pass. Training vereist beide passes, terwijl inferentie alleen het forward-formaat gebruikt.
"We vonden dat forward-tensors hogere fidelity nodig hebben – meer precisie in de mantissa – terwijl gradienten een wijdere dynamische range met een grotere exponent eisen. Deze trade-off leidde tot de 1-4-3 (teken-exponent-mantissa) split voor forward en een 5-bit exponent voor backward, wat een dynamische range van 232 geeft. Onze hardware ondersteunt nu beide varianten."
Hiërarchische accumulatie
IBM's "hiërarchische accumulatie"-techniek verlaagt precisie tijdens accumulatie naast gewichten en activaties. Traditionele FP16-training accumuleert in 32-bit-aritmetiek om nauwkeurigheid te behouden, maar het 8-bit-schema accumuleert in FP16. Door lange accumulaties in kleinere chunks te groeperen en die op te tellen, minimaliseert de chip afrondingsfouten zonder de voordelen van lagere precisie op te offeren.
"Duizenden getallen achtereen optellen kan precisie degraderen," legde Gopalakrishnan uit. "Chunking van de accumulatie houdt de som nauwkeurig terwijl de hardware lean blijft."
Low-precision inferentie
Terwijl de meeste inferentie-engines INT8 gebruiken, demonstreerde IBM dat 4-bit integer-aritmetiek state-of-the-art nauwkeurigheid kan evenaren. Na quantisatie vermindert een quantisatie-aware training-stap de nauwkeurigheidsverlies tot minder dan 0,5%, wat acceptabel is voor veel toepassingen.
On-chip Ring
De chip bevat een network-on-chip geoptimaliseerd voor deep learning, wat cores in staat stelt om data efficiënt te multicasten. Dit vermindert off-chip geheugenverkeer en bandbreedte-eisen.
"We ontkoppelden de ring's operatiefrequentie van de cores', wat onafhankelijke optimalisatie en hogere core-snelheden toestaat zonder de long-wire-latentie van de ring," zei Ankur Agrawal, research staff member in machine learning en accelerator-architecturen.
Stroombeheer
IBM introduceerde een frequentie-schaalschema dat de chip dicht bij zijn stroom-envelop houdt gedurende de workload. Door de initiële spanning en frequentie agressief in te stellen, behoudt de chip hoge prestaties tijdens compute-zware fasen en past zich aan aan lagere eis zonder dure spanning-wijzigingen.
"Deep-learning workloads hebben duidelijke stroom-pieken en -dalen," merkte Agrawal op. "Onze strategie houdt stroomverbruik stabiel, wat dalen omzet in prestatiewinst."
Testchip
Het 4-core-ontwerp balanceert connectiviteitscomplexiteit met core-grootte, wat een schaalbare architectuur biedt. IBM voorziet 1-2 core chips voor edge-apparaten en 32-64 core chips voor datacenter-implementaties, allemaal capabel van FP16, hybride FP8, INT4 en INT2.
"Verschillende applicatiedomeinen eisen verschillende precisie- en energie-trade-offs," zei Gopalakrishnan. "Onze Zwitserse-zaakmes van formaten laat ons elk use-case targeten zonder efficiëntie in te boeten."
De hardware complementerend, lanceerde IBM Research de "Deep Tools" compiler-stack, wat 60-90% utilizatie op de chip bereikt.
Volgens een eerdere interview zouden low-precision AI-chips gebaseerd op deze architectuur binnen twee jaar de markt moeten bereiken.
>> Dit artikel is oorspronkelijk gepubliceerd op onze zustersite, EE Times.
Gerelateerde Inhoud:
- AI-chips behouden nauwkeurigheid met modelreductie
- AI-modellen trainen op de edge
- De race is open voor AI op de edge
- Edge AI uitdaagt geheugentechnologie
- Engineering-groep streeft naar 1mW AI op de edge
- Neurale netwerken toepassing voor small-scale taken
- AI IC-onderzoek verkent alternatieve architecturen
Voor meer Embedded, abonneer je op Embedded's wekelijkse e-mailnieuwsbrief.
Ingebed
- Onderhoud managen tijdens personeelsverkleining: Strategisch outsourcen & continue monitoring
- Rockwell Automation partner met ATCC om automatiseringstraining uit te breiden over centraal Minnesota
- Top 10 Precisie-onderdelen Geproduceerd door CNC-werktuigmachines
- Verhoog uw marketing ROI met agency-niveau precisie
- IBM: Asset Betrouwbaarheid & Veiligheid Verbeteren met Proactieve EAM Oplossingen
- Verhoog Uw Marketing ROI met Agentschapsnauwkeurigheid
- Precisiebewerking: Bouwen van superieure hydraulische systemen voor productie & bouw
- Bluetooth Mesh-ontwerpkeuzes: Module vs. discreet apparaat
- MIT-doorbraak: 1,6 mm² cryptografische ID-chip bestrijdt namaak met terahertz-backscatter
- Onderzoekers onthullen BrakTooth: 16 Bluetooth Classic kwetsbaarheden blootleggen 1.400+ ESP32 apparaten
- Hoe IBM Watson AI-innovatie drijft in diverse industrieën